AI展现优化
-
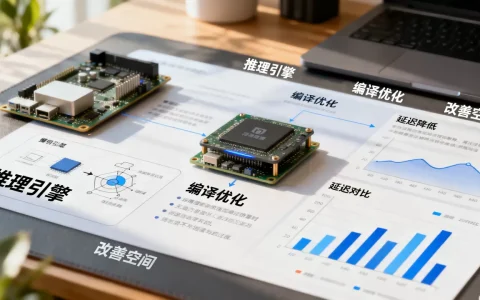
推理引擎编译优化能降低多少延迟,延迟改善空间有多大?
推理引擎编译优化对延迟的改善空间相当可观,在多数场景下能将单次推理的P99延迟降低一个肉眼可见的量级,部分复杂模型甚至能获得接近翻倍的提速,但具体收益高度依赖模型结构、硬件平台和编译策略的匹配度,推理引擎编译优化到底在优化什么很多人把编译优化当成一个黑盒,觉得把模型扔进去跑个编译就完事了,编译优化干的活非常具体……
-
存储与计算分离架构在训练中的落地
存储与计算分离架构在训练场景的落地,核心结论是:训练阶段越靠近“数据准备”和“模型保存”,存储与计算分离的价值越大;越靠近“微批次计算”,本地缓存越必要,主流做法是构建“远端大容量共享存储+近端高速缓存”的混合架构,这套架构不是非此即彼的选择题,训练任务的数据流存在明显的冷热分层:热数据是当前迭代正在读取的样本……
-
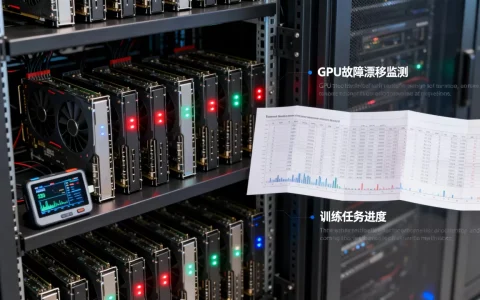
GPU故障漂移对长训练任务的影响评估
GPU故障漂移是长训练任务最大的隐性杀手,它不会直接让训练崩溃,而是通过间歇性性能下降、微小计算错误和悄无声息的降频,让训练时间拉长、模型质量受损,甚至让数周的算力投入化为泡影,GPU故障漂移到底“漂”在哪:从稳定到崩塌的四个阶段GPU故障漂移(GPU Fault Drift)指的是显卡从健康状态到完全失效之间……
-
模型并行切分粒度的权衡与经验
模型并行切分粒度的选择没有绝对最优解,核心在于匹配你的集群拓扑、显存容量与计算效率;粗粒度省通信但显存浪费严重,细粒度显存均衡但通信开销指数级上升,实操中往往需要在两者之间找到性价比拐点,这几年做大模型训练,并行策略几乎是绕不开的坎,你可能会搜到各种关于模型并行训练切分粒度怎么选的文章,但真正落地时,很多人还是……
-
数据并行下每卡批次大小怎么调,需要注意什么?
数据并行下每卡批次大小怎么调?核心思路是:先跑通单卡最优的per-gpu batch size,再按卡数线性扩展成global batch size;显存不够时用梯度累积缩减每卡batch,同时按比例调学习率,数据并行下每卡批次大小怎么调?先分清global和local很多人调参时只盯着一个batch size……
-
模型权重热更新是否影响服务可用性,怎么办?
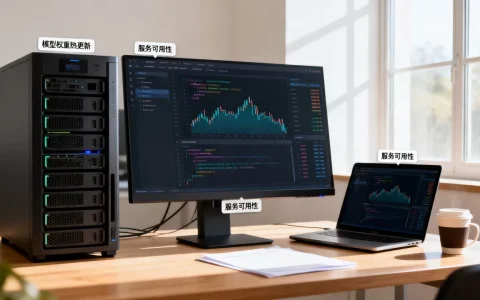
模型权重热更新能在不影响线上服务的前提下完成推理能力升级,但前提是做好内存管理、版本兼容和回滚预案,否则热更新本身反而会成为可用性的最大风险源,模型权重热更新,简单说就是服务不重启、请求不中断,把新旧权重在内存里做完交接,听起来很优雅,但真正在线上跑过的人都知道,这里面的坑比想象中多,很多团队第一次做热更新,满……
-
边缘推理场景下的低功耗显卡考量
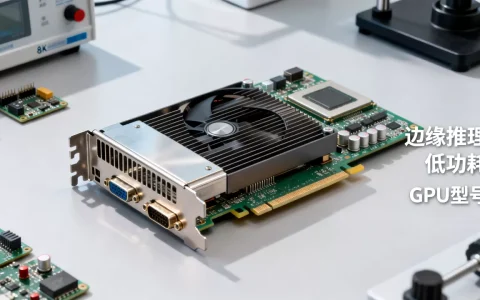
边缘推理场景选低功耗显卡,结论只有一句话:别只盯着峰值算力,把功耗墙、散热体积和长期TCO算清楚,比参数翻倍更值钱,边缘推理这几年从“能跑就行”卷到了“跑得稳、跑得省”,矿卡和游戏卡靠高功耗堆算力的路子,在嵌入式工控机、AGV小车、智慧灯杆这些场景里根本走不通,边缘推理场景用什么显卡,本质上是在算力、功耗、价格……
-
大模型量化部署对精度损失的评估
大模型量化部署的精度损失是可控的,关键在于选对量化方法、校准数据与评估方式,多数场景下4-bit量化可保留95%以上的模型能力,但代码生成、数学推理等敏感任务需谨慎验证,模型瘦身的代价:量化到底动了谁的蛋糕量化像给模型做减脂手术,把原本FP16的32位浮点参数压缩成INT8甚至INT4,参数变瘦了,显存占用随之……
-
显存池化技术如何落地推理平台?,推理平台显存不足怎么办?
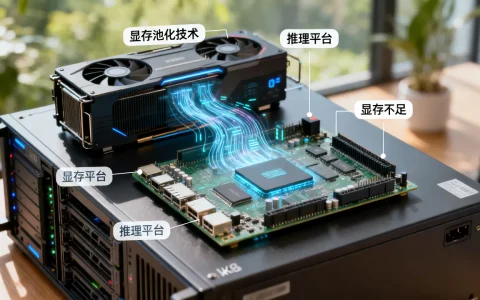
显存池化技术能不能在推理平台落地?答案是能,而且已经被不少团队验证过,关键是把性能损耗控制在可接受范围内,同时把资源占用降下来,围绕落地尝试的真实路径展开,不绕弯子,直接讲怎么判断、怎么选、怎么做,显存池化技术怎么落地?先看推理平台的显存痛点显存不够用怎么办?别急着加卡,先搞清楚显存去哪了推理平台最常见的场景是……
-
服务网格在推理微服务间扮演什么通信角色?,什么是服务网格
服务网格在推理微服务间扮演的是流量调度、策略执行与可观测性三位一体的通信底座角色,核心价值在于让模型调用的稳定性不依赖单个服务的编码质量,而是下沉到基础设施层统一治理,这个结论听起来有点抽象,换个说法:当你的推理服务从单体变成几十个微服务互相调用时,超时、重试、熔断、灰度切流这些事如果还在每个服务里用代码写一遍……