AI展现优化
-
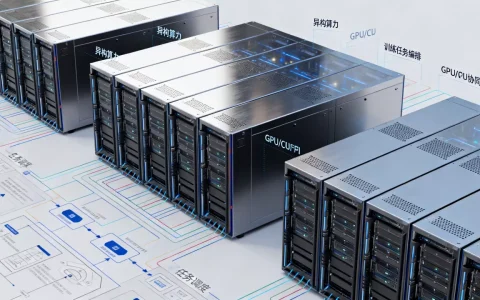
异构算力环境训练任务如何编排?,什么是异构算力?
异构算力环境下训练任务的编排,本质不是排队,而是让每一张GPU都找到最擅长它的活,这套方法论的核心是把不同型号、不同代际、甚至不同厂商的算力统一抽象成可调度的资源池,再通过拓扑感知与数据亲和策略,把训练任务分配到能跑得最快的位置上,异构算力环境下训练任务编排怎么做:从排队到分发的三个关键步骤第一步:把异构资源……
-
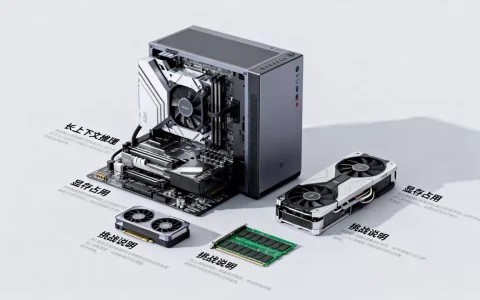
长上下文推理对显存占用的挑战说明
长上下文推理的显存挑战,核心在于KV Cache随序列长度线性增长,序列越长,显存占用越恐怖,单纯堆算力或买卡并不解决根本问题, 真正值得关注的,不是模型权重占了多少显存,而是每一轮生成时都要存下“已经看过的所有内容”,上下文从2K涨到128K,模型参数量一个字节没变,显存账单却可能翻几十倍,下面把这个问题拆开……
-
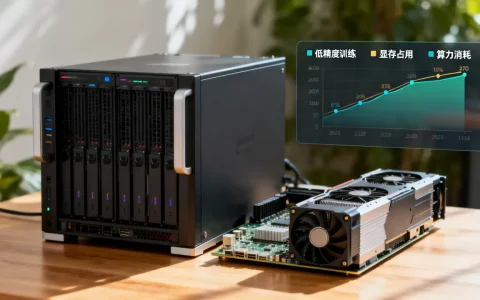
低精度训练对显存与算力的双重收益
低精度训练能在不更换硬件的情况下,同时降低显存占用并提升计算吞吐,是当前大模型微调和推理部署中最具性价比的显存优化手段,如果你正在为显卡显存不足而烦恼,或者觉得训练速度慢得让人心焦,那么这篇文章就是为你准备的,我们会把低精度训练这个技术掰开揉碎,看看它到底是怎么在显存和算力这两件事上“两头通吃”的,也会聊聊实际……
-
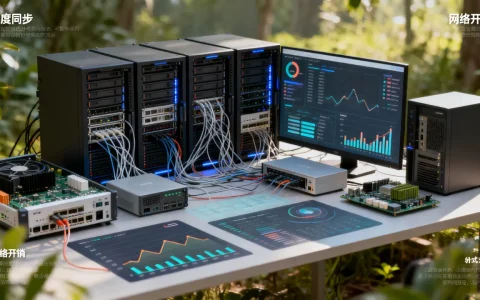
分布式训练梯度同步的网络开销估算
分布式训练中梯度同步的网络开销,本质上取决于模型参数量、并行策略与集群带宽三者的乘积关系;估算它,用一条公式就能算出数量级,搞大模型训练的人,迟早会撞上“通信墙”,显卡算力上去了,数据搬运不过来,几千张卡等你一个梯度,这个开销怎么估算,是规划训练集群、设计并行方案必须跨过的第一道坎,梯度同步开销该怎么算,先抓住……
-
推理服务弹性扩缩容的队列设计经验
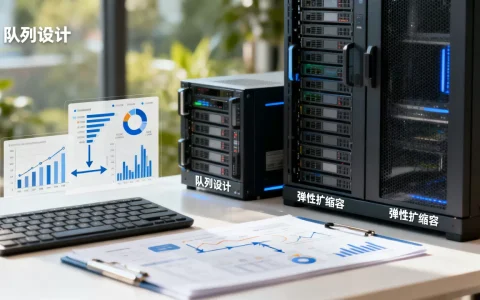
让队列长度成为扩缩容的触发信号,而非单纯依赖CPU或GPU利用率,这样才能在流量洪峰到来时提前一步完成资源准备,队列不仅是请求的缓冲区,更是流量与资源之间的“蓄水池”,它直接决定了推理服务在面对突发流量时的生死存亡,为什么排队延迟高总是出现在扩容完成之前做过推理服务的人都有这种体会:流量一上来,监控面板上的排队……
-
GPU服务器机箱散热风道怎么选,机箱风道设计对散热影响大吗?
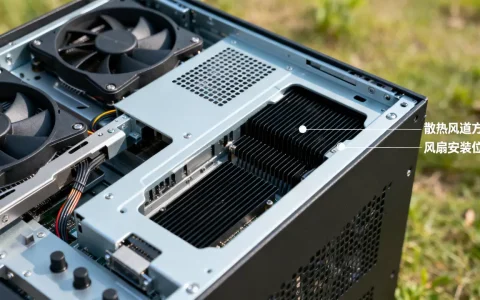
GPU服务器机箱的风道设计直接决定散热效率与硬件寿命,选型时应优先考虑直通式风道结构,搭配高静压风扇与合理的风量布局,而非单纯堆砌风扇数量,散热不良的根源,往往是风道规划失衡——GPU的热量无法被有效带离,导致降频、宕机甚至硬件损坏,GPU服务器散热不好怎么解决:先从风道结构看起GPU服务器和普通CPU服务器的……
-
多机多卡通信拓扑如何影响收敛速度?,有什么好处
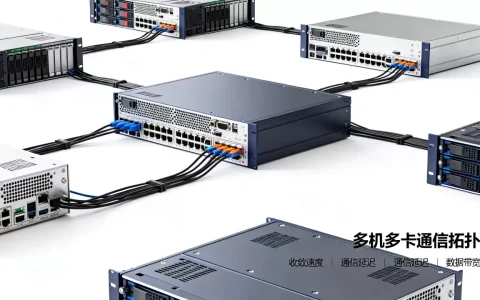
多机多卡训练收敛速度的核心瓶颈往往不在算力,而在通信拓扑的选择与配置,它决定了梯度同步的效率和GPU利用率,直接影响每一步迭代耗时,进而决定模型能否在预期时间内收敛,实际部署中,机间通信带宽远低于机内NVLink,拓扑结构放大了这一差距,通信拓扑是多人协作的分工方式——环形接力稳但怕掉棒,树状汇报快但怕根节点拥……
-
数据加载成为训练瓶颈时如何优化?,有哪些优化方向?
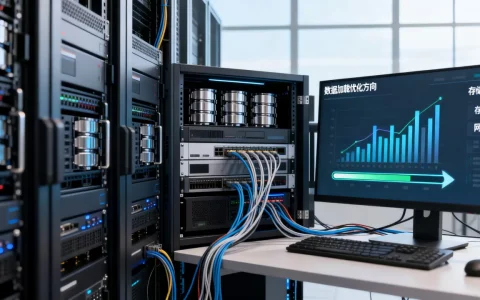
数据加载成为训练瓶颈时,核心解法就是让数据管线的每一层都跑起来,用多进程并行和预取把等待时间抹平,模型训练时GPU空转、显存吃不满,根源不在于算力不够,而是数据供给跟不上,这个问题在CV、NLP、推荐系统的大规模训练里相当常见,搞明白优化方向比盲目加显卡更管用,先确认瓶颈到底在不在数据加载这段不少同学一看GPU……
-
大模型微调显卡选型成本高吗,怎么选才便宜?
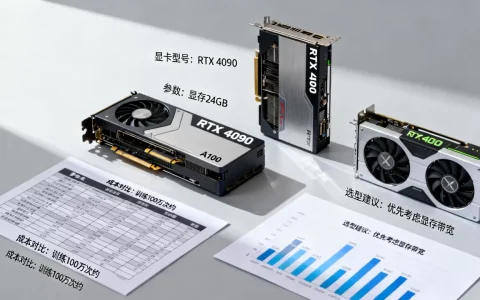
大模型微调阶段选显卡,核心不是看算力跑分多高,而是看显存容量和有效带宽能不能装下你的模型和优化器状态,预算有限时,租卡往往比买卡更划算,微调和预训练是两码事,预训练像开荒,什么都要硬扛;微调更像在熟地上精耕细作,目标明确、数据量小、训练轮次少,这个区别直接决定了你在显卡上的钱该怎么花,很多团队在预训练阶段咬咬牙……
-
如何加速训练集群中的容器镜像分发?,有什么优化方案?
训练集群的镜像分发加速,核心不是把带宽管道加粗,而是让节点之间互相“借货”,把单点仓库的压力拆成一张P2P网络,再配合调度亲和、镜像预热和瘦身,才能根治大规模拉起时的镜像卡顿,为什么镜像分发在训练集群里特别慢普通业务集群一次发布,可能只有几十个Pod在拉镜像,仓库扛得住,训练集群不是这个玩法,一个分布式训练任务……