大模型的Top-P采样是一种通过设定概率阈值来动态过滤低概率候选词,从而在生成内容的多样性和连贯性之间取得平衡的核心算法机制。
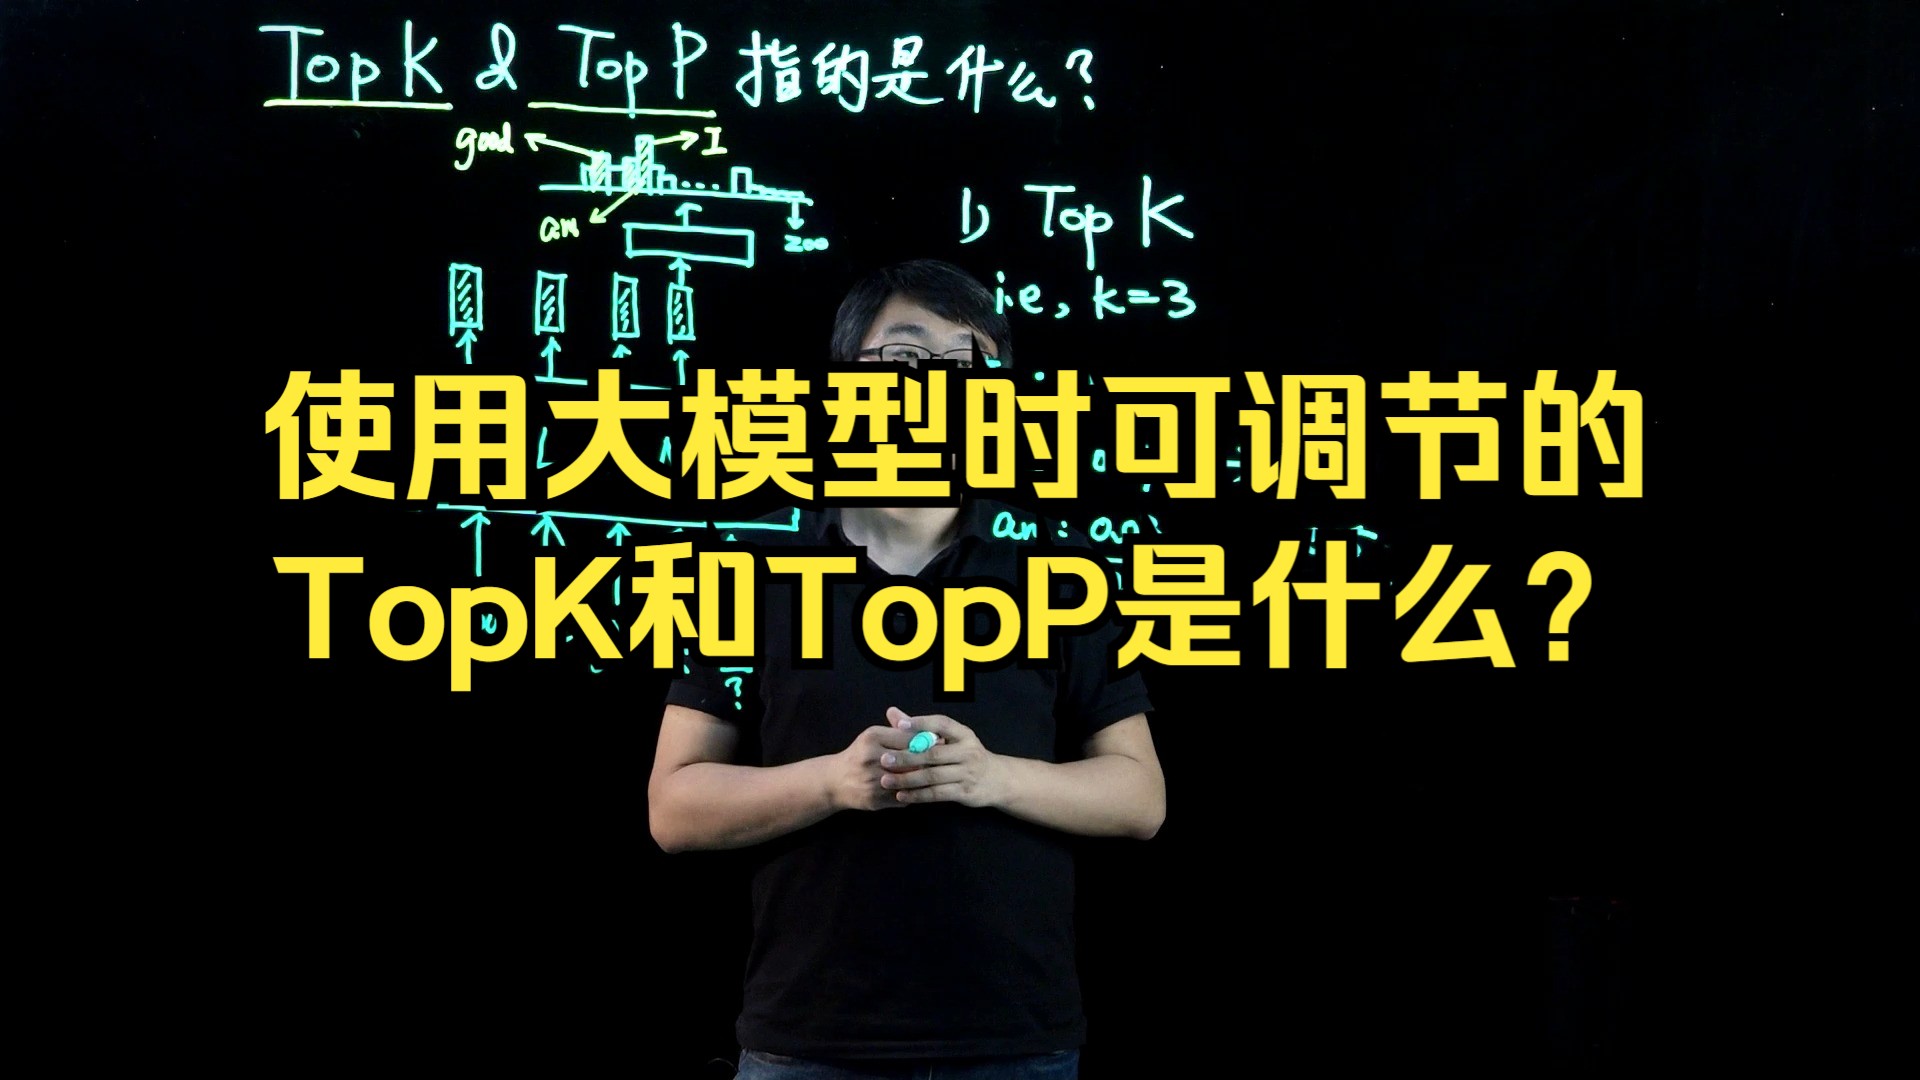
在理解这一概念之前,我们需要先厘清大语言模型(LLM)生成文本的基本逻辑,模型并不是在“思考”,而是在进行一场极其复杂的概率预测游戏,当你输入一个提示词后,模型会基于海量训练数据,为下一个可能出现的词计算出一个概率分布,面对“床前明月”这四个字,模型可能会判断“光”出现的概率是0.8,“盘”是0.1,而“苹果”的概率仅为0.0001,传统的Top-K采样是强行保留概率最高的K个词,而Top-P则更加灵活,它关注的是累积概率。

Top-P采样的底层逻辑与运作机制
Top-P,全称为Nucleus Sampling(核采样),其核心理念在于“截断尾部”,它不关心具体有多少个词,而是关心这些词加起来是否达到了你设定的概率阈值P,假设我们将P设置为0.9,模型会将候选词按概率从高到低排序,然后不断累加它们的概率,直到总和达到0.9为止,所有被累加进来的词构成了最终的“候选池”,模型只从这个池子中随机抽取下一个词。
为什么需要动态截断而不是固定数量
传统的Top-K方法存在明显的局限性,如果P值固定为K=5,那么在“床前明月”这种高置信度场景下,可能前两个词“光”和“盘”的概率之和就已经超过了90%,剩下的三个词毫无意义,甚至可能引入噪音,而在创意写作等低置信度场景下,前5个词的累积概率可能还远未达到90%,强行截断会导致模型无词可选或被迫选择极不合理的词,Top-P通过动态调整候选词的数量,解决了这一痛点。
业内专家指出,这种机制允许模型在确定性高的语境中表现得更加严谨,而在创造性语境中保持足够的开放性。

具体操作路径与参数影响
在实际应用中,调整Top-P参数对生成结果有显著影响,以下是不同设置下的典型表现:
- Top-P接近0(如0.1):模型几乎只选择概率最高的那个词,输出内容高度确定,但可能显得机械、重复,缺乏变化。
- Top-P适中(如0.7-0.9):这是大多数通用场景的最佳区间,模型能够排除明显错误的选项,同时保留合理的多样性,生成的文本既通顺又具有一定的创造性。
- Top-P接近1(如0.99或1.0):模型几乎保留所有非零概率的词,包括那些极不可能的词,这会导致输出内容充满幻觉、逻辑跳跃甚至乱码,虽然看似“自由”,实则失控。
Top-P与Top-K及Temperature的对比分析
为了更清晰地理解Top-P的价值,我们需要将其与另外两个常见的采样参数进行对比,许多用户在配置大模型API时,容易混淆这三个概念。
核心差异点解析
| 特性 | Top-K | Top-P (Nucleus) | Temperature |
|---|---|---|---|
| 筛选依据 | 固定数量的最高概率词 | 累积概率达到阈值的词集合 | 调整概率分布的平滑程度 |
| 灵活性 | 低,固定K值 | 高,动态调整候选集大小 | 中,全局调整概率分布 |
| 适用场景 | 需要严格控制输出长度的场景 | 大多数通用对话、创意写作 | 需要调整整体随机性的场景 |
| 潜在风险 | 高置信度时浪费算力,低置信度时无词可选 | 设置过高会导致幻觉,过低则僵化 | 设置过高导致逻辑混乱,过低导致重复 |

协同工作的最佳实践
在实际部署中,Top-P通常与Temperature配合使用,Temperature负责调整概率分布的“陡峭”或“平缓”程度,而Top-P负责在分布确定后,剔除尾部噪音,行业共识认为,对于代码生成等需要高准确性的任务,建议将Top-P设置得较低(如0.1-0.3),并配合较低的Temperature;而对于故事创作、头脑风暴等任务,则可以将Top-P设置在0.7-0.9之间,以激发更多样的创意。
不同场景下的Top-P参数优化策略
理解原理只是第一步,如何在具体业务场景中调优Top-P,才是决定大模型应用效果的关键,不同的任务类型对“确定性”和“创造性”的需求截然不同。
代码生成与逻辑推理场景
在编写Python代码或进行数学推理时,错误的概率分布往往会导致语法错误或逻辑漏洞,模型需要极高的确定性,建议将Top-P设置为0.1至0.3,在让模型修复一段Bug时,如果Top-P过高,模型可能会尝试一种虽然概率稍低但语法错误的修复方案,低Top-P能确保模型始终在最高置信度的代码片段中进行选择,从而大幅提高代码的正确率和可执行性。
创意写作与营销文案场景
撰写小说情节或广告标语时,我们需要的是“意料之外,情理之中”,如果Top-P设置过低,生成的文案可能会千篇一律,缺乏新意,建议将Top-P提升至0.7

至0.9,这种设置允许模型在合理的词汇范围内进行更多样的组合,从而产生更具吸引力和独特性的表达,在生成“夏日饮品”的描述时,低Top-P可能只会生成“冰镇”、“清爽”等高频词,而高Top-P则可能引入“气泡”、“微醺”等更具画面感的词汇。
客服对话与事实问答场景
客服机器人需要在准确性和流畅性之间找到平衡,Top-P过高会导致胡言乱语,过低则显得生硬,0.5至0.7是一个较为安全的区间,结合RAG(检索增强生成)技术,将Top-P与外部知识库结合使用,可以进一步降低幻觉风险,据统计,在引入外部知识源后,适当放宽Top-P限制并不会显著增加错误率,反而能提升对话的自然度。
常见问题解答
大模型的Top-P采样与Top-K采样哪个更好
Top-P通常被认为优于Top-K,因为它能根据上下文动态调整候选词的数量,在确定性高的语境中,Top-P会自动缩小候选集,避免Top-K可能引入的无关词汇;在创造性语境中,Top-P会扩大候选集,避免Top-K因固定数量而限制创意,Top-P在大多数场景下提供了更好的平衡。
如何设置Top-P参数以避免大模型产生幻觉
减少幻觉的关键在于降低Top-P的值,通常建议设置为0.1至0.3,较低的概率阈值会强制模型只选择最高置信度的词,从而减少生成无关或错误信息的可能性,结合清晰的提示词工程和RAG技术,可以进一步约束模型的生成范围,确保输出内容的事实准确性。
Top-P参数对生成速度有影响吗
Top-P参数本身对生成速度的影响微乎其微,生成速度主要取决于模型的参数量、硬件算力以及上下文长度,Top-P只是在模型计算完概率分布后的后处理步骤,其计算开销相对于整个推理过程来说可以忽略不计,调整Top-P主要是为了优化生成质量,而非性能。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/409282.html