HR数据库设计的核心在于构建高内聚低耦合的数据模型,通过规范化处理消除冗余,并利用索引与分区技术保障海量员工数据在查询时的毫秒级响应,从而支撑企业从基础人事管理向智能化人才决策转型。
在数字化转型的深水区,人力资源管理系统(HRMS)早已超越了简单的“存名字、发工资”阶段,随着企业规模扩张,员工档案、考勤记录、绩效评分、薪酬结构等数据呈指数级增长,如果底层数据库设计粗糙,系统卡顿、数据不一致、报表生成缓慢将成为常态,业内专家指出,优秀的HR数据库设计不仅是技术架构问题,更是业务逻辑的数字化映射,它需要平衡数据的一致性、查询效率以及扩展性,确保在应对大规模并发访问时依然稳定可靠。
HR数据库设计的关键原则与架构选型
设计一个健壮的HR数据库,首先要解决的是“怎么存”和“怎么连”的问题,这直接决定了后续功能开发的难易程度以及系统未来的扩展空间。
关系型与非关系型数据库的对比选择
在技术选型上,许多团队会在MySQL、PostgreSQL等关系型数据库(RDBMS)与MongoDB等非关系型数据库(NoSQL)之间犹豫,HR数据具有极强的结构化特征,如员工ID、部门代码、职位等级等,这些字段之间的关系严密,适合使用关系型数据库。
对于非结构化数据,如员工的简历附件元数据、360度评估中的自由文本反馈、培训视频标签等,NoSQL数据库则更具优势,行业共识认为,混合架构是当前的最佳实践,核心人事主数据(Core HR)必须存放在关系型数据库中,以保证ACID事务特性,确保薪资计算等关键操作的准确性;而行为数据、日志数据或非结构化文档则存入NoSQL数据库,以换取更高的写入吞吐量和灵活性。
数据规范化与反规范化的平衡
数据库设计理论强调第三范式(3NF),旨在通过拆分表来消除数据冗余,将“部门信息”单独建表,员工表中只保留“部门ID”,这种做法在数据量较小、写入频繁的场景下非常有效,但在HR系统中,我们面临的是复杂的报表查询需求。
如果在生成月度人力成本报表时,每次都需要关联员工表、部门表、岗位表、薪酬表,性能损耗巨大,在关键查询路径上,适当引入反规范化策略是必要的,在员工表中冗余存储“部门名称”或“当前职级”,虽然增加了数据更新的复杂度,但大幅提升了读取效率,这种权衡需要根据具体的业务场景进行微调,不能一概而论。
核心实体模型设计与字段规范
HR数据库的灵魂在于实体模型的设计,一个清晰的ER图(实体关系图)是开发团队沟通的通用语言,我们需要重点关注员工生命周期中的核心实体及其关联关系。
员工主数据与组织架构映射
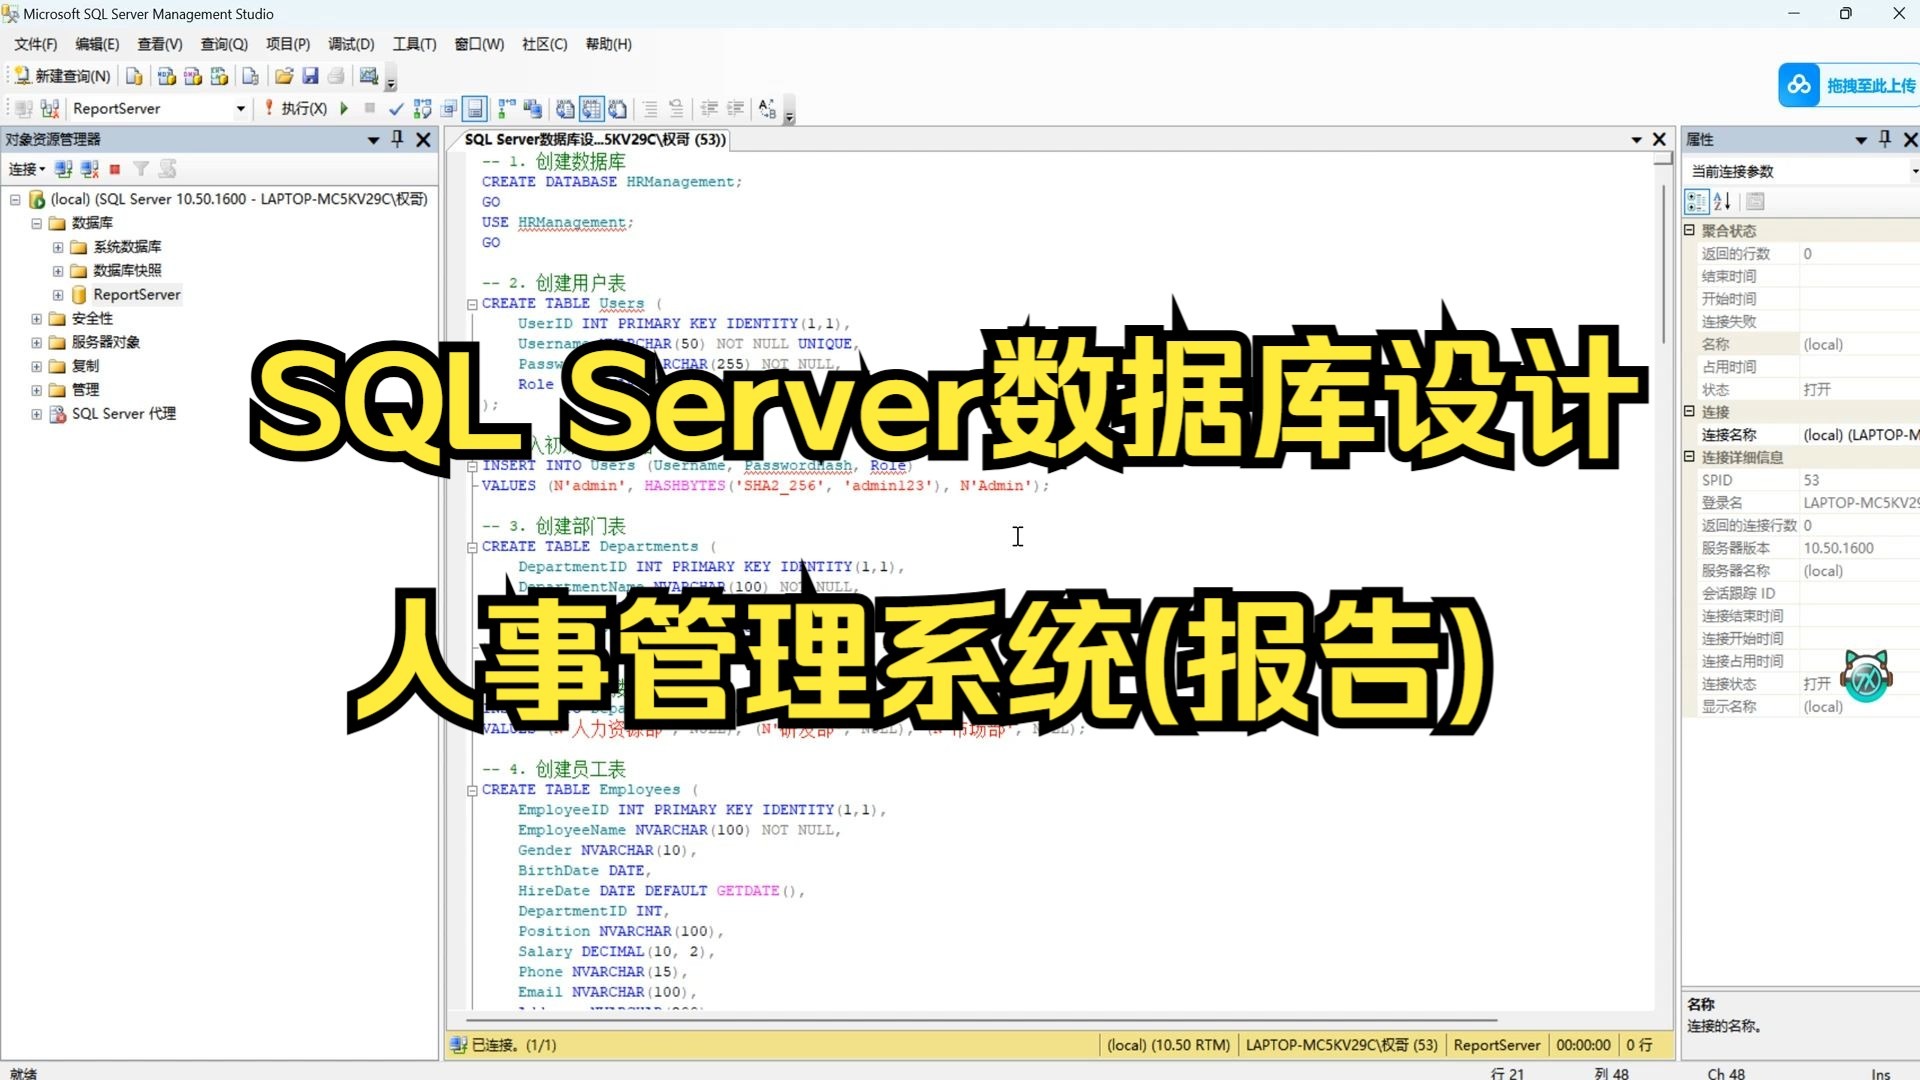
员工表(Employee)是系统的核心,除了基本身份信息,必须包含“入职日期”、“离职日期”、“在职状态”等关键字段,以便快速筛选活跃员工,组织架构通常采用树形结构存储,推荐使用邻接表模型或闭包表模型(Closure Table)。
邻接表模型结构简单,适合层级不深的组织;闭包表模型则能高效处理多层级查询,如“获取某部门下所有子部门的员工列表”,对于大型集团企业,闭包表模型在查询效率上优势明显,尽管其维护成本稍高,需建立员工与岗位的映射关系,支持一人多岗或一人多职的历史记录追踪,通过版本控制字段记录每次变更的时间戳和操作人。
薪酬绩效数据的隔离与加密
薪酬数据属于最高敏感级别,在设计上,必须将薪酬表与员工基本信息表物理隔离,甚至部署在不同的数据库实例中,字段设计上,薪资数值应使用Decimal类型而非Float,避免精度丢失。
对于绩效数据,建议采用宽表设计,将不同考核周期(月度、季度、年度)的结果存入同一张表,通过“考核周期ID”和“员工ID”联合索引进行区分,这样既避免了表数量过多导致的维护困难,又便于横向对比员工在不同周期的表现,值得注意的是,所有敏感字段在数据库中必须加密存储,密钥管理与数据分离,确保即使数据库文件泄露,攻击者也无法直接获取明文薪资信息。
性能优化与高可用架构实战
当数据量达到百万级甚至千万级时,查询速度成为瓶颈,单纯的SQL优化已不足以解决问题,需要从索引策略、分区技术以及读写分离等多个维度入手。
索引策略与查询优化路径
索引是提升查询速度的利器,但滥用索引会降低写入性能,在HR系统中,高频查询场景包括:按姓名/工号查询员工、按部门统计人数、按入职年份筛选等,针对这些场景,应建立复合索引,为“部门ID”和“入职日期”建立联合索引,可以极大加速“某部门年度新人统计”这类报表的生成。
避免在索引列上进行函数运算或类型转换,这会导致索引失效,不要使用WHERE YEAR(hire_date) = 2026,而应使用范围查询WHERE hire_date >= '2026-01-01' AND hire_date < '2026-01-01',定期使用EXPLAIN命令分析执行计划,识别全表扫描和低效连接,是日常运维的必要动作。
大数据量下的分区与归档策略
对于考勤记录、审批日志等随时间线性增长的数据,采用表分区技术是提升性能的有效手段,按月份或季度对考勤表进行分区,使得查询特定时间段的数据时,数据库引擎只需扫描对应的分区,而非全表。
建立数据归档机制,将超过一定年限(如3年)的历史数据迁移至冷存储或历史表中,保持主表轻量化,这不仅提升了在线系统的响应速度,也符合数据合规性要求,便于长期存储成本的控制,据工信部相关数据显示,合理的数据生命周期管理可使存储成本降低30%以上。
常见误区与避坑指南
在实际落地过程中,许多HR系统项目因设计缺陷导致后期重构,以下是几个高频出现的错误场景及解决方案。
硬编码业务逻辑
错误做法:将“转正日期=入职日期+3个月”的逻辑写死在数据库触发器或应用代码中。
正确做法:将计算规则配置化,存储在配置表中,这样当公司政策调整(如试用期改为6个月)时,只需修改配置,无需重新发布代码。
忽视数据一致性校验
错误做法:依赖前端表单验证,后端不做二次校验。
正确做法:在后端服务层和数据库约束层双重校验,设置外键约束确保“部门ID”必须存在于部门表中;设置唯一约束防止同一员工在同一时间段内存在多条在职记录。
缺乏审计日志
错误做法:直接覆盖更新敏感字段。
正确做法:建立独立的审计日志表,记录每次修改前后的值、操作人、操作时间,这对于处理薪资纠纷、权限追溯至关重要。
HR数据库设计Q&A
HR数据库设计如何平衡查询速度与数据更新效率?
通过读写分离架构解决,主库负责事务性写入(如入职、调薪),从库负责报表查询,对于高频读取但低频更新的维度表(如职位字典、部门树),可采用缓存机制(如Redis)减轻数据库压力,对于必须实时一致的关联数据,利用数据库的物化视图或定时同步任务,在业务低峰期更新聚合数据,从而在写入时保持轻量,在读取时保持高速。
如何处理跨国企业的多时区与多语言数据?
时间字段统一使用UTC格式存储,在应用层根据用户所在时区进行转换展示,避免数据库层面的时区混乱,多语言数据建议采用JSONB类型存储翻译内容,或建立独立的翻译映射表,通过语言代码(Locale)关联,这样既保证了核心数据的一致性,又灵活支持多语言扩展,无需为每种语言重建表结构。
HR数据库设计中的权限控制如何实现数据隔离?
采用基于行的安全策略(Row-Level Security, RLS),在数据库层面定义策略,普通HR只能查询自己所在部门的数据,而集团HR可查看全量数据,通过动态过滤条件自动附加到查询语句中,确保即使SQL注入发生,攻击者也无法越权获取数据,这种细粒度的控制比应用层权限校验更底层、更安全,能有效防止内部数据泄露风险。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/358700.html