


生产工厂引入AI大模型并非简单的软件升级,而是通过重构数据流与决策链,实现从“经验驱动”向“数据智能驱动”的根本性转型,从而显著降低运维成本并提升良品率。
传统制造业正站在转型的十字路口,过去,工厂依赖老师傅的经验判断设备状态,依赖人工肉眼检测产品瑕疵,这种模式在规模化生产面前显得脆弱且低效,随着算力成本的下降和算法的成熟,AI大模型开始深入车间核心环节,它不再是一个遥不可及的概念,而是变成了能听懂机器语言、看懂生产视频、读懂工艺参数的“超级员工”。
生产工厂ai大模型落地场景解析
AI大模型在工厂中的应用,核心在于解决三个痛点:预测性维护、质量检测优化以及生产调度智能化,这些场景并非孤立存在,而是相互交织,共同构成智能工厂的底座。
设备预测性维护:从“坏了再修”到“未病先防”
设备非计划停机是制造业最大的隐形杀手,传统维护方式要么是定期保养,成本高且可能过度维护;要么是事后维修,损失巨大,AI大模型通过接入传感器数据,能够建立设备的“数字孪生”体。
- 数据采集层:实时采集振动、温度、电流等多维时序数据。
- 特征提取层:利用大模型的时序处理能力,识别微小异常模式。
- 决策输出层:提前预警潜在故障,并推荐最佳维护窗口期。
业内专家指出,通过部署预测性维护系统,多数情况下可将非计划停机时间减少30%以上,同时延长关键设备的使用寿命,这种转变让维修团队从“救火队员”变成了“健康管理师”。
视觉质检升级:解决复杂缺陷识别难题
传统机器视觉依赖固定算法,面对新产品或复杂背景时,调试周期长、误判率高,AI大模型具备强大的泛化能力,能够理解“什么是瑕疵”的本质,而非仅仅匹配像素差异。
- 少样本学习:只需提供少量缺陷样本,模型即可快速适应新产线。
- 多模态融合:结合图像、声音甚至气味数据,综合判断产品质量。
-

自进化机制:随着生产数据积累,模型自动优化识别逻辑,越用越准。
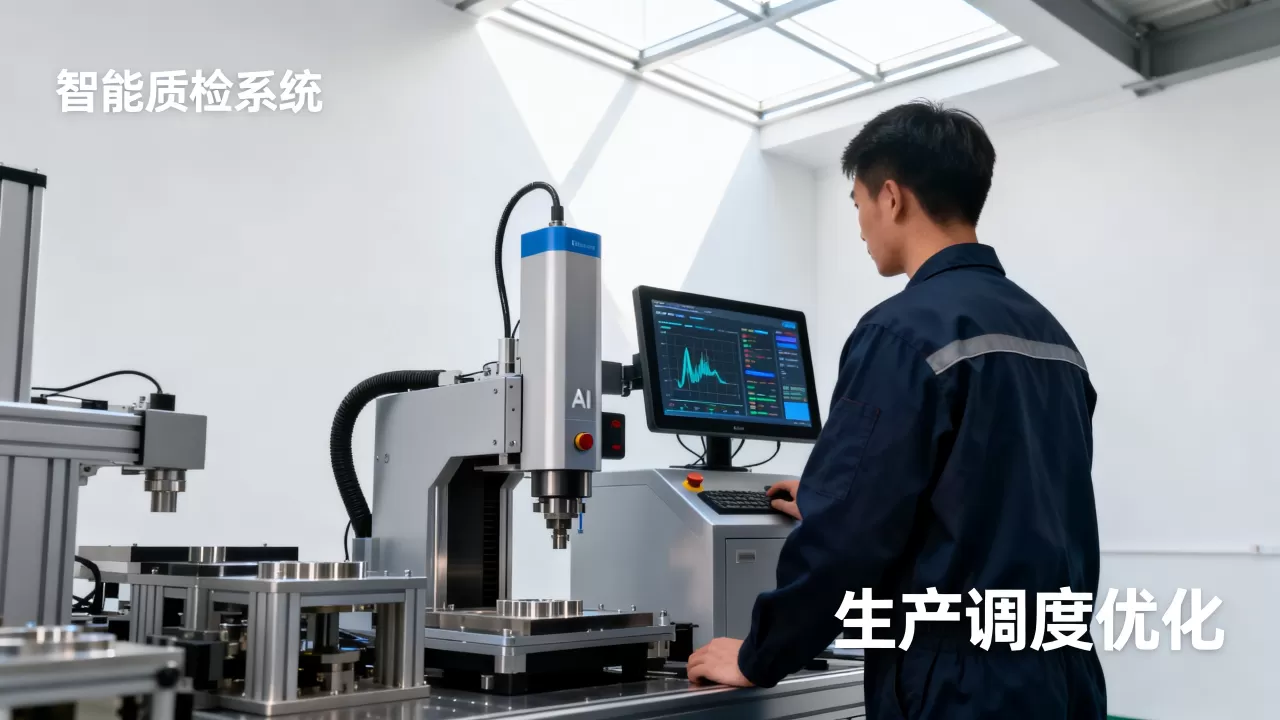
对于生产工厂ai大模型应用案例而言,电子元件引脚弯曲、纺织品微小污渍等复杂缺陷的检测准确率,在引入大模型后有了显著提升,这不仅降低了漏检率,还大幅减少了人工复检的工作量。
生产工厂ai大模型实施路径与成本考量
许多管理者在考虑引入AI时,最关心的往往是投入产出比和实施难度,成功的落地并非一蹴而就,而是需要分阶段推进。
第一阶段:数据治理与基础搭建
没有高质量的数据,AI就是无米之炊,许多工厂存在数据孤岛问题,ERP、MES、SCADA系统数据互不相通,第一步必须是打通数据链路,确保数据格式统一、标注规范。
- 清洗数据:剔除噪声数据,填补缺失值。
- 统一标准:建立统一的数据字典和元数据管理。
- 构建平台:搭建私有化或混合云AI算力平台,确保数据安全。
据工信部相关数据显示,数据质量直接决定了AI模型最终效果的70%以上,这一阶段看似枯燥,却是决定项目成败的关键。
第二阶段:场景试点与价值验证
不要试图一次性解决所有问题,选择一个痛点明确、数据基础好、业务价值高的场景进行试点,先在一个关键工序或一条产线进行试点。
- 定义指标:明确衡量成功的KPI,如良品率提升幅度、停机时间缩短比例。
- 快速迭代:采用敏捷开发模式,每周评估模型效果,及时调整参数。
- 对比验证:设置对照组,客观评估AI介入前后的差异。
第三阶段:规模化推广与生态构建
当试点成功后,再将模式复制到其他车间或工厂,重点转向模型的可扩展性和生态整合。
- 模块化封装:将通用能力封装成API,方便其他系统调用。
- 人才培训:培养既懂工艺又懂数据的复合型人才。
- 持续运营:建立模型监控机制,防止模型老化或漂移。
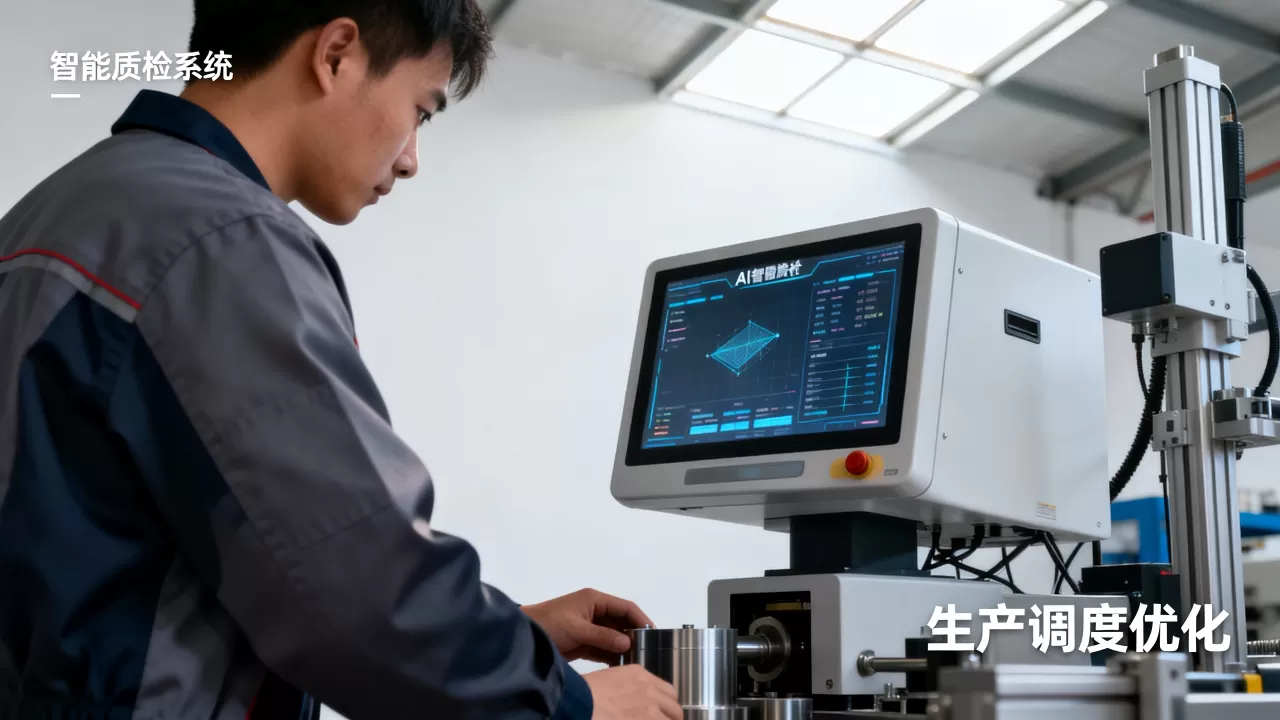
生产工厂ai大模型价格,市场差异较大,小型单点应用可能仅需数十万元,而覆盖全厂的定制化解决方案则可能高达数百万甚至上千万元,企业应根据自身规模和预算,选择适合的方案,避免盲目追求大而全。
生产工厂ai大模型选型对比与避坑指南
面对市场上琳琅满目的AI服务商,企业容易陷入选择困难,不同的技术路线和商业模式,适合不同阶段的企业。
通用大模型 vs 垂直行业模型
通用大模型能力强,但缺乏行业Know-how,容易产生“幻觉”,在严谨的工业场景中风险较高,垂直行业模型经过特定数据训练,更懂工艺逻辑,准确率更高,但泛化能力相对较弱。
| 维度 | 通用大模型 | 垂直行业大模型 |
|---|---|---|
| 数据需求 | 海量通用数据 | 高质量行业专有数据 |
| 定制成本 | 较低(需微调) | 较高(需深度训练) |
| 行业理解 | 浅层,易出错 | 深层,符合工艺逻辑 |
| 适用场景 | 文档处理、客服辅助 | 工艺优化、故障诊断 |
行业共识认为,对于核心生产环节,建议优先选择垂直行业模型或基于通用模型进行深度微调的方案,以确保安全性和准确性。
公有云 vs 私有化部署
数据安全性是工厂的核心机密,公有云部署成本低、弹性好,但存在数据泄露风险,私有化部署数据完全可控,但初期投入大,维护成本高。
- 敏感数据:如配方、工艺参数,必须私有化部署。
- 非敏感数据:如行政办公、通用客服,可使用公有云。
- 混合架构:采用“核心私有+边缘公有”的混合模式,兼顾安全与成本。
生产工厂ai大模型未来趋势与挑战
AI大模型在工厂的应用才刚刚开始,未来几年将出现更多创新形态。
边缘智能与云端协同
随着5G和边缘计算技术的发展,越来越多的AI推理任务将在边缘端完成,实现毫秒级响应,云端负责模型训练和全局优化,边缘端负责实时控制,形成“云边端”协同架构。
生成式设计优化
AI不仅用于监控和优化,还将参与产品设计,通过生成式设计,AI可以根据性能要求自动生成最优结构方案,大幅缩短研发周期。
人机协作新模式
未来的工厂不是无人工厂,而是人机协作工厂,AI负责处理海量数据和复杂计算,人类负责创意、决策和情感交互,操作员通过自然语言与AI对话,即可获取生产建议,降低使用门槛。
生产工厂ai大模型常见问题解答
生产工厂ai大模型实施周期通常需要多久?
实施周期取决于项目规模和复杂度,数据治理和基础搭建通常需要1-3个月,场景试点和模型训练需要2-4个月,规模化推广则需要6-12个月,整体来看,从启动到全面见效,通常需要半年到一年的时间,企业需做好长期投入的心理准备,避免急功近利。
生产工厂ai大模型对现有IT架构有什么要求?
AI大模型需要强大的算力支持和稳定的数据流,现有IT架构需具备以下能力:一是具备足够的存储和计算资源,或能无缝对接云服务;二是数据接口标准化,能实时采集多源异构数据;三是网络安全防护到位,确保数据在传输和处理过程中的安全性,建议企业在项目启动前,先进行IT架构评估和升级规划。
生产工厂ai大模型能完全替代人工吗?
AI大模型无法完全替代人工,而是作为辅助工具提升效率,在重复性高、危险性大、精度要求高的环节,AI可以替代部分人工操作,但在需要创造力、复杂决策和情感沟通的环节,人类依然不可或缺,未来的人机协作模式,将是AI处理数据,人类处理例外和情感,两者互补共生。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/374582.html

评论列表(1条)
讲真啦,老师傅经验靠不住?够用就得!人工检瑕疵成本太高,AI能省则省吧。