分布式缓存服务通过内存读写、节点横向扩展及高可用架构,能显著提升系统响应速度并降低数据库负载,是构建高性能互联网应用的核心基础设施。
为什么传统数据库扛不住高并发?
想象一下,你是一家电商平台的后端工程师,双11零点,流量瞬间涌入,成千上万的请求同时指向你的MySQL数据库,磁盘I/O成为瓶颈,查询延迟从几毫秒飙升到几秒,甚至直接导致服务雪崩,这就是单机数据库在海量并发面前的脆弱性。

业内专家指出,随着互联网业务复杂度的指数级增长,单纯依靠增加数据库硬件配置(垂直扩展)已无法满足性能需求,分布式缓存应运而生,它就像是在数据库前面加了一道“快速安检通道”,将热点数据提前加载到内存中,从而极大缓解了后端存储的压力。
内存与磁盘的速度鸿沟
要理解缓存的价值,首先要看清底层硬件的物理极限,内存(RAM)的读写速度比传统机械硬盘(HDD)快几个数量级,即便对比固态硬盘(SSD),内存依然占据绝对优势。
- 延迟对比:内存访问延迟通常在纳秒级(ns),而SSD的随机读取延迟在微秒级(us),机械硬盘更是高达毫秒级(ms)。
- 吞吐量差异:内存带宽足以支撑每秒数百万次的读写操作,而数据库受限于磁盘IO和锁机制,并发处理能力有限。
通过引入Redis或Memcached等分布式缓存,绝大多数读请求可以直接在内存中完成,无需触碰磁盘,这种架构调整,使得系统能够从容应对突发流量。
缓存穿透与击穿的风险
虽然缓存优势明显,但并非万能药,如果设计不当,缓存本身也会成为新的故障点,当大量请求查询不存在的数据时,会直接打到数据库,这就是“缓存穿透”,或者当某个热点Key过期时,大量并发请求同时穿透到数据库,造成“缓存击穿”。
解决这些问题需要精细化的策略,比如布隆过滤器、互斥锁或逻辑过期方案,这些技术手段确保了分布式缓存服务优势能够真正转化为业务稳定性。

分布式缓存的核心技术优势解析
分布式缓存不仅仅是把数据存到内存里,它通过复杂的算法和架构设计,解决了单机缓存无法解决的扩展性和一致性问题。
水平扩展能力
单机缓存受限于单台服务器的内存大小和CPU性能,当数据量超过单机容量时,系统就会崩溃,分布式缓存允许你通过增加节点来线性提升整体容量和性能。
- 弹性伸缩:业务高峰期,动态增加缓存节点;低谷期,释放资源以节省成本。
- 负载均衡:数据自动分片存储在不同节点上,避免单点过载。
这种机制使得系统具备极强的弹性,能够适应业务规模的快速增长,对于寻求分布式缓存服务价格合理的中小企业而言,按需扩容的模式比一次性购买昂贵的大型服务器更具性价比。
高可用与数据持久化
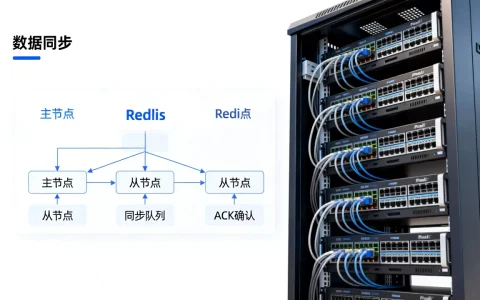
内存是易失性存储,断电即失,分布式缓存通过主从复制、哨兵机制或集群模式,确保数据的多副本存储。
- 故障自动转移:当主节点宕机,哨兵系统会自动选举新的主节点,业务无感知。
- 数据持久化:支持RDB快照和AOF日志,定期将内存数据写入磁盘,防止数据丢失。
这种设计保证了服务的高可用性(High Availability),即使在硬件故障的情况下,也能维持业务连续运行。
一致性哈希算法
在分布式环境中,如何高效地将数据映射到不同节点是一个难题,传统的哈希取模算法在节点增减时会导致大量数据重新分布,引发“缓存雪崩”。
一致性哈希算法通过构建一个虚拟的哈希环,使得节点增减时,只有少量数据需要迁移,这不仅减少了网络开销,还提高了系统的稳定性。
实战场景下的性能提升效果
理论再好,不如实战验证,在实际业务场景中,分布式缓存能带来哪些具体的改变?

电商商品详情页
商品详情页数据变化频率低,但访问量极大,将商品信息、价格、库存等热点数据放入缓存,可以将数据库QPS降低90%以上。
- 操作流程:用户请求商品详情 -> 检查缓存 -> 命中则直接返回 -> 未命中则查库并回写缓存。
- 效果:页面加载时间从秒级缩短至毫秒级,用户体验显著提升。
社交网络动态Feed流
微博或朋友圈的动态生成涉及复杂的关联查询,通过缓存预计算好的Feed流,可以避免每次请求都进行复杂的数据库Join操作。
- 数据模型:采用“推模式”或“拉模式”结合,将好友动态聚合后存入缓存列表。
- 优势:大幅降低数据库负载,支持千万级用户同时在线浏览。
选型与部署的关键考量
面对市场上琳琅满目的缓存产品,如何选择最适合的方案?
Redis vs Memcached
Redis和Memcached是两大主流选择,它们各有侧重。
| 特性 | Redis | Memcached |
|---|---|---|
| 数据结构 | 支持String, List, Hash, Set, ZSet等丰富结构 | 仅支持简单的Key-Value字符串 |
| 持久化 | 支持RDB和AOF,数据不丢失 | 不支持持久化,重启后数据清空 |
| 集群方案 | 原生支持Cluster,无需额外组件 | 需依赖客户端哈希或代理 |
| 适用场景 |
复杂数据结构、需要持久化、排行榜等 | 简单KV存储、极致性能、临时缓存 |

多数情况下,Redis因其丰富的数据结构和持久化能力,成为大多数新项目的首选,但对于对延迟极度敏感且数据结构简单的场景,Memcached依然有其用武之地。
云托管 vs 自建集群
自建分布式缓存集群需要投入大量人力进行运维、监控和故障排查,对于大多数企业而言,选择云服务商提供的分布式缓存服务优势更为明显。
- 运维简化:云厂商负责底层硬件维护、补丁升级和故障恢复。
- 按需付费:根据实际使用量付费,降低初期投入成本。
- 生态集成:与云上的数据库、计算资源无缝集成,网络延迟更低。
据工信部数据,近年来采用云原生架构的企业比例显著上升,其中缓存服务的云化部署是重要组成部分。
常见问题解答
分布式缓存服务优势主要体现在哪些方面?
分布式缓存服务优势主要体现在三个方面:一是通过内存读写大幅提升系统响应速度,降低延迟;二是通过水平扩展能力支撑海量并发请求,避免数据库瓶颈;三是通过高可用架构保障业务连续性,减少单点故障风险。
如何解决缓存与数据库的数据一致性问题?
解决一致性问题通常采用延迟双删、订阅Binlog异步更新或设置较短的过期时间等策略,业内共识认为,在大多数互联网场景中,允许短暂的数据不一致以换取高性能是可接受的,具体策略需根据业务对数据强一致性的要求来定。
分布式缓存服务价格如何计算?
分布式缓存服务价格通常基于实例规格(内存大小、CPU核数)、带宽用量及存储时长计算,云服务商多提供按量付费和包年包月两种模式,企业可根据业务波动情况选择最经济的计费方式,避免资源闲置浪费。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/487567.html