没有显卡怎么跑大模型?云端部署大模型教程

没有独立显卡也能跑大模型,核心方案是利用CPU进行量化推理、调用云端免费算力或借助开源轻量级框架,虽然速度不及GPU,但完全足以满足日常逻辑处理与内容生成需求。

很多用户被“大模型必须配高端显卡”的营销话术劝退,其实随着模型压缩技术的进步,普通办公电脑甚至老旧笔记本也能胜任轻量级任务,我们不再依赖昂贵的硬件堆砌,而是转向软件优化与云端协同,这种转变让AI平民化成为可能,关键在于选择正确的工具和策略。
【喂饭教程】10分钟手把手教会你通过云服务器部署Qwen3-8B模型,全程干货无废话,小白也可以轻松上手!大模型/LLM/模型部署
加载中
【喂饭教程】10分钟手把手教会你通过云服务器部署Qwen3-8B模型,全程干货无废话,小白也可以轻松上手!大模型/LLM/模型部署

本地部署:利用CPU与内存挖掘潜力

对于不想泄露数据、追求隐私安全的用户,本地部署是首选,即使没有NVIDIA显卡,现代处理器(如Intel Core i7/i9或AMD Ryzen 7/9)配合大内存,依然能流畅运行经过量化的开源模型。

量化技术是关键突破口

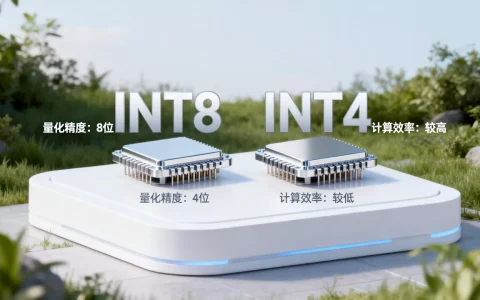
大模型参数巨大,直接加载需要海量显存,量化技术通过降低精度(如从FP16降至INT4或INT8),在保持模型智能水平的同时,大幅减少资源占用,业内专家指出,INT4量化后的模型在多数通用任务中,效果损失可忽略不计,但显存需求可降低75%。

具体操作步骤

  1. 准备环境:安装Python 3.10+环境,确保内存至少16GB,推荐32GB以上。
  2. 选择模型:下载经过Qwen2.5或Llama3等框架量化后的GGUF格式模型,这些格式专为CPU优化设计。
  3. 运行工具:使用llama.cpp或Ollama等工具,Ollama对新手更友好,只需一行命令即可启动。
  4. 没有显卡怎么跑大模型?云端部署大模型教程

  5. 执行命令:在终端输入ollama run qwen2.5:7b,系统会自动下载并启动模型,此时CPU占用率会升高,风扇声音可能变大,但交互延迟通常在可接受范围内。

内存带宽决定推理速度

没有显卡意味着失去了专用并行计算单元,转而依赖系统内存带宽,双通道内存比单通道能显著提升推理速度,据统计,使用DDR5双通道内存的笔记本,其推理速度比DDR4单通道快近一倍。

云端算力:零硬件门槛的替代方案

如果本地设备性能过弱,或者需要处理更复杂的长文本,云端平台是最佳选择,这里不涉及购买服务器,而是利用各大平台提供的免费或低成本推理接口。

免费平台对比与选择

许多AI平台为了推广生态,提供了免费的API调用额度或Web端对话服务,这些服务后端通常配备高性能A100或H100集群,用户无需关心底层硬件。

平台类型 代表服务 优势 劣势
在线对话平台 通义千问、文心一言 无需配置,开箱即用,中文理解极佳 隐私性较低,不适合敏感数据
开源社区托管

没有显卡怎么跑大模型?云端部署大模型教程

Hugging Face Spaces 可尝试各类最新开源模型 排队时间长,免费实例性能受限
云厂商试用 阿里云PAI、腾讯云TI 提供一定额度的免费GPU算力 配置复杂,需注册认证

API调用的实操路径

通过代码调用API是最灵活的方案,以Python为例,你可以轻松接入主流大模型。

  1. 注册账号:在百度智能云或阿里云注册开发者账号,获取API Key。

  2. 安装SDK:运行pip install baidu-aip或pip install dashscope。

  3. 编写脚本:

    import dashscope
    from dashscope.api_client.dashscope_original import Generation
    dashscope.api_key = '你的API_KEY'
    response = Generation.call(
        model="qwen-turbo",
        messages=[{'role': 'user', 'content': '解释一下量子计算'}]
    )
    print(response.output.text)

    这种方式完全屏蔽了硬件差异,无论你的电脑多么老旧,只要网络通畅,就能获得顶级算力支持。

浏览器端运行:WebGPU技术的崛起

近年来,WebGPU技术的成熟使得浏览器也能分担部分计算任务,这意味着你甚至不需要安装Python或任何软件,直接在网页上就能运行轻量级模型。

没有显卡怎么跑大模型?云端部署大模型教程

浏览器推理的优势

浏览器利用WebGPU接口,直接调用用户设备的GPU(即使是集成显卡)或CPU进行计算,这种方式安全性极高,因为数据无需离开浏览器沙箱。

推荐工具

  • MLC LLM:支持在浏览器中运行经过优化的LLM,适合移动端和低端PC。
  • WebLLM:专注于浏览器内的本地推理,支持ChatML格式,交互流畅。

使用场景建议

这种方式适合快速原型验证或轻度对话,对于需要长期记忆或复杂逻辑的任务,仍建议回到本地部署或云端方案。

常见问题解答

没有显卡怎么跑大模型才不卡顿?

卡顿主要源于内存带宽不足和量化精度选择,建议优先选择INT4或INT8量化的模型,并确保使用双通道内存,若本地运行仍慢,建议切换至云端API调用,后者几乎无感知延迟。

本地CPU跑大模型与云端GPU相比价格如何?

本地部署是一次性硬件投入,边际成本为零,适合高频、私密场景,云端API按Token计费,初期免费额度通常足够个人用户日常使用,超出后按量付费,总体成本可控且无需维护硬件。

没有显卡怎么跑大模型才能保护隐私?

本地部署是唯一能确保数据不离开设备的方式,使用Ollama或LM Studio等工具,配合离线下载的GGUF模型,可实现完全离线运行,数据不会上传至任何服务器,从根本上保障隐私安全。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://idctop.com/article/401349.html

赞 (0)
Ubuntu 20.04如何安装PHP7.4?php7.4安装教程
上一篇 2026年6月19日 16:37
宝塔面板怎么关闭默认404页面?如何自定义404错误页
下一篇 2026年6月19日 16:40

相关推荐

  • Ollama怎么用systemd管理?如何设置开机自启动

    使用systemd管理Ollama的核心在于创建标准的.service单元文件,通过systemctl enable和start命令实现开机自启与后台驻留,从而彻底告别手动终端运行的繁琐,在2026年的本地AI部署场景中,服务器稳定性是首要考量,许多开发者习惯在终端直接运行ollama serve,但这意味着一……

    2026年6月19日
    4300
  • 如何选择iaas云服务中的存储云服务?,选哪个好?

    选云存储不是看品牌名气,而是先认清你的数据长什么样、怎么被访问,再对号入座选类型——选错类型,再贵的存储也是浪费,先搞懂三种存储的脾气:块存储、文件存储、对象存储很多人一上来就问“阿里云和腾讯云哪个存储好”,这其实问错了方向,云厂商只是房东,真正决定体验的是你租的房型,业内专家指出,超过七成的存储选型失误,根源……

    2026年8月21日
    900
  • 服务器是如何匹配域名的?,配置方法有哪些?

    服务器匹配域名,核心就是通过DNS系统将域名解析到服务器IP,并在服务器软件中配置虚拟主机或站点绑定,整个过程涉及DNS记录设置和服务端配置两个环节,服务器绑定域名:从DNS解析到配置实战DNS解析负责将域名翻译成服务器能识别的IP地址,服务器配置则决定当访问到达时,该响应哪个站点,两者缺一不可,域名解析到服务……

    2026年7月20日
    1700
  • 分布式数据库方案

    分布式数据库方案的选择没有标准答案,但根据业务场景匹配架构,比盲目追求技术栈更重要, 在2026年的今天,数据量爆发式增长,单体数据库早已不堪重负,无论是互联网大厂还是传统企业,都在加速向分布式架构迁移,但面对琳琅满目的方案,很多人会纠结:是继续在中间件上花功夫,还是直接上原生分布式数据库?云服务商提供的托管方……

    2026年7月27日
    400
  • 负载均衡https配置失败怎么办,负载均衡https证书部署教程

    负载均衡HTTPS的核心在于通过SSL卸载或终止技术,将加密解密压力从后端服务器剥离,由负载均衡器统一处理,从而显著提升网站安全性与访问速度,在2026年的互联网环境中,HTTPS已不再是可选项,而是标配,随着业务规模扩大,单纯在后端服务器部署证书导致CPU飙升、响应延迟增加的问题愈发突出,负载均衡器作为流量入……

    2026年7月9日
    16300
  • IIS服务器架构如何安装?,详细步骤有哪些

    在Windows Server上部署网站,IIS(Internet Information Services)是原生且成本最低的选择,正确做法是:先用PowerShell命令快速安装核心组件,再根据实际架构需求补充功能模块,最后完成站点绑定,很多朋友第一次打开服务器管理器,看到IIS那一长串角色服务就发懵,别急……

    2026年8月21日
    900
  • 大模型INT8和INT4有何区别?大模型量化INT8和INT4怎么选

    INT8量化将模型精度从32位降至8位,推理速度提升约2倍,显存占用减半,适合大多数生产环境;INT4进一步降至4位,速度再提升2-3倍,显存再减半,但精度损失较大,需配合微调或特定硬件支持,适合对延迟极度敏感且能容忍轻微精度下降的边缘场景,大语言模型在落地应用中,量化技术是平衡性能与成本的关键杠杆,随着模型参……

    2026年6月22日
    2600
  • 国内自主AI大模型有哪些?2026年最新排名及评测

    国内自主AI大模型已全面进入“百模大战”向“生态融合”过渡的深水区,当前主流选择应优先考虑百度文心一言、阿里通义千问及华为盘古等具备全栈算力适配能力的头部产品,具体选型需严格依据企业私有数据安全性、现有IT基础设施兼容性以及实际业务场景的复杂度来决定,国内主流大模型核心能力横向对比在2026年的市场格局中,国内……

    2026年6月15日
    19500
  • Ollama如何兼容OpenAI API?Ollama调用OpenAI接口教程

    通过部署Ollama并配置反向代理或中间件,可以将本地运行的开源模型转换为符合OpenAI API标准的接口,从而实现代码层面的无缝兼容,这种兼容方案的核心在于解决“协议差异”而非“模型能力差异”,OpenAI API定义了一套标准的RESTful接口规范,包括请求格式、响应结构以及流式传输协议,Ollama原……

    2026年6月19日
    2800
  • 服务器监控指标对性能有何影响?,关键指标有哪些?

    服务器监控指标是保障业务稳定运行的生命线,核心指标包括CPU使用率、内存占用、磁盘I/O、网络流量和响应时间,缺一不可,任何一个指标出现异常,都可能导致服务中断或用户体验下降,本文从实操角度出发,拆解这些指标的意义、获取方式以及在不同场景下的选型策略,帮你快速建立一套有效的监控体系,服务器监控指标有哪些?核心指……

    2026年7月23日
    1500

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注