GPU服务器本身并不像微信或APP那样具备原生的“推送消息服务”功能,它需要依赖操作系统层面的监控代理、第三方云管平台或自定义脚本,才能实现故障报警、任务完成或资源异常的消息推送。
在2026年的AI算力基础设施环境中,GPU服务器作为训练大模型和推理服务的核心硬件,其稳定性直接决定了业务连续性,很多开发者或运维人员容易混淆“硬件状态”与“消息通知”的概念,硬件本身只负责计算,它不会主动“说话”,要实现消息推送,必须构建一套从底层硬件监控到上层应用通知的完整链路,这不仅是技术问题,更是运维效率的关键。
GPU服务器消息推送的技术实现路径
要实现有效的消息推送,首先需要明确数据的来源和传输通道,业内专家指出,目前主流的实现方式主要分为硬件层监控、系统层代理和云平台集成三种路径。
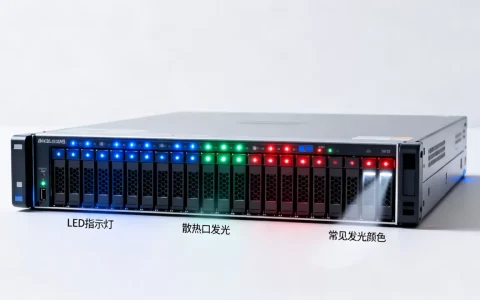
基于IPMI与BMC的底层硬件监控
这是最基础也是最可靠的方式,BMC(基板管理控制器)是服务器主板上的一块独立芯片,即使服务器关机或操作系统崩溃,它依然独立运行。
- 监控对象:温度、电压、风扇转速、电源状态、GPU核心温度。
- 实现逻辑:BMC检测到异常(如GPU温度超过85℃),通过SNMP协议或SMTP邮件协议发送告警。
- 适用场景:机房物理环境监控,适用于无人值守的数据中心。
- 局限性:配置复杂,通常只能发送电子邮件,无法直接推送到手机或即时通讯软件。
操作系统层面的Agent监控方案
当服务器操作系统(如Ubuntu、CentOS、Rocky Linux)正常运行时,可以通过安装监控代理(Agent)来获取更细粒度的GPU信息。
- 核心工具:NVIDIA DCGM(Data Center GPU Manager)、Prometheus + Node Exporter、Zabbix Agent。
- 操作流程:
- 在GPU服务器上安装DCGM Exporter。
- 配置Exporter暴露端口(默认9400),提供GPU利用率、显存使用率、ECC错误计数等指标。
- 将数据推送至Prometheus时序数据库。
- 配置Alertmanager规则,当指标超过阈值时触发通知。

- 优势:数据粒度极细,可以精确到单个GPU核心的功耗和温度,支持Webhook对接企业微信、钉钉或Slack。

云平台原生监控服务
如果使用的是公有云GPU实例(如阿里云、腾讯云、AWS),则无需自建监控链路,云平台提供了开箱即用的监控服务。
- 服务名称:阿里云云监控、腾讯云云监控、AWS CloudWatch。
- 功能特点:自动采集GPU利用率、显存占用、PCIe带宽等指标。
- 推送方式:在控制台设置“报警规则”,绑定“短信+电话+邮件”或“钉钉机器人” webhook。
- 优势:零代码配置,稳定性高,无需维护监控服务器。
不同场景下的推送策略选择
选择合适的推送方案,取决于你的使用场景、预算和技术栈,不同场景对实时性和准确性的要求差异巨大。
个人开发者本地训练
对于在本地机房或小型服务器集群上进行模型训练的开发者,成本敏感且技术能力有限。
- 推荐方案:NVIDIA DCGM + 简单Python脚本。
- 实操步骤:
- 编写Python脚本,调用
nvidia-smi或DCGM CLI获取GPU状态。 - 使用
requests库调用企业微信/钉钉的Webhook接口。 - 设置crontab定时任务,每分钟执行一次检查。
- 当发现OOM(显存溢出)或温度异常时,发送JSON格式的消息卡片。
- 编写Python脚本,调用
- 优点:完全免费,灵活度高,可自定义消息内容。
企业级大规模集群运维
对于拥有数百甚至数千张GPU卡的企业,人工巡检不现实,需要自动化、标准化的监控体系。
- 推荐方案:Prometheus + Grafana + Alertmanager + 企业IM机器人。
- 核心数据:据统计,采用Prometheus生态的企业,故障平均发现时间(MTTD)可缩短至分钟级。
- 配置要点:
- 部署Grafana Dashboard,可视化展示集群GPU健康状态。
- 在Alertmanager中配置静默规则,避免非工作时间误报。
- 对接企业微信/钉钉/飞书机器人,实现@特定责任人。
- 集成ITSM系统(如Jira Service Management),实现告警自动建单。
- 优点:可扩展性强,支持多级告警,便于追溯历史故障。

云原生Kubernetes环境
在K8s集群中调度GPU任务,需要关注Pod级别的GPU资源分配和容器健康状态。
- 推荐方案:Kube-state-metrics + NVIDIA Device Plugin + 云厂商监控。
- 关键点:
- 确保NVIDIA Device Plugin正确运行,将GPU资源暴露给K8s。
- 使用
kubectl top pods查看实时资源消耗。 - 结合云厂商的“容器服务监控”插件,实现跨节点的全局视图。
- 优势:与K8s原生集成,支持自动扩缩容时的资源预警。
常见误区与优化建议
在实际部署中,许多团队容易陷入一些误区,导致告警风暴或漏报。
避免告警风暴
当GPU服务器发生物理故障(如断电、网络中断)时,所有监控Agent会同时失效,导致大量告警瞬间涌入。
- 优化策略:
- 分组告警:将同一机柜或同一批次的服务器归为一组,只发送一条汇总告警。
- 静默机制:在维护窗口期或已知故障期间,自动静默相关告警。
- 去重规则:在Alertmanager中配置相同标签的告警在5分钟内只发送一次。
确保推送通道的可靠性
消息推送失败比没有告警更糟糕,因为它会给人造成“一切正常”的假象。
- 多通道冗余:同时配置短信、邮件和IM机器人,当IM机器人超时未响应时,自动降级为短信通知。
- 心跳检测:定期发送测试消息,验证推送通道是否畅通。
- 本地日志:在推送失败时,将告警信息写入本地日志文件,以便后续排查。
GPU特定指标的监控重点

除了常规的CPU和内存监控,GPU有独特的故障模式,需要重点关注。
- Xid Errors:NVIDIA驱动会记录Xid错误码,如Xid 79表示GPU硬件错误,Xid 43表示显存ECC错误,监控这些错误码比监控温度更能提前发现硬件隐患。
- GPU利用率波动:如果训练任务中GPU利用率突然降至0,可能意味着数据加载瓶颈或代码死锁,而非硬件故障。
- 温度梯度:监控GPU核心温度与外壳温度的差值,异常大的温差可能暗示散热系统故障。
GPU服务器是否有推送消息服务相关Q&A
GPU服务器是否有推送消息服务的免费替代方案?
是的,存在多种免费替代方案,对于个人开发者,可以使用NVIDIA DCGM配合简单的Python脚本,通过Webhook将告警发送到免费的IM工具(如企业微信、钉钉、Slack)机器人,对于小规模集群,可以使用Prometheus和Alertmanager的组合,这两个组件均为开源免费软件,只需自行部署服务器即可实现完整的监控和推送链路,无需支付额外的云服务费用。
GPU服务器是否有推送消息服务在Kubernetes集群中如何配置?
在Kubernetes集群中,通常不直接在GPU节点上配置推送服务,而是通过集群级别的监控组件实现,部署NVIDIA Device Plugin以暴露GPU资源,安装Prometheus Operator和Grafana,配置Node Exporter和DCGM Exporter采集GPU指标,在Alertmanager中配置Webhook接收器,指向企业微信或钉钉的机器人地址,当Pod级别的GPU资源异常或节点级别的硬件故障发生时,Alertmanager会自动发送格式化消息到指定的IM群组。
GPU服务器是否有推送消息服务时如何避免误报?
避免误报的关键在于设置合理的阈值和告警策略,根据历史数据设定动态阈值,而非固定值,例如将温度告警阈值设为过去24小时平均温度的1.2倍,实施告警分组和去重,将同一故障源引发的多个告警合并为一条,第三,配置静默规则,在已知维护期间或测试环境中自动屏蔽告警,定期审查告警规则,移除长期未触发的无效规则,确保告警系统的精准性和有效性。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/423042.html