通过Hive将数据保存至MySQL的核心方法是利用Sqoop工具或Hive的JDBC输出格式进行数据导出,关键在于配置正确的连接参数并处理数据类型映射。
在大数据生态系统中,Hive负责海量数据的离线分析与存储,而MySQL则常用于支撑业务系统的实时查询,将两者打通,意味着你可以将Hive中经过复杂清洗和聚合后的“高价值数据”推送给前端应用,实现数据价值的最终落地,这一过程并非简单的复制粘贴,而是涉及数据流转、格式转换和性能优化的系统工程。

技术选型:Sqoop与原生JDBC导出的对比分析
业内专家指出,选择合适的数据导出工具是项目成功的第一步,目前主流方案主要有两种:使用Apache Sqoop专用工具,或者利用Hive内置的JDBC输出格式。
Sqoop:大数据导出的行业标准
Sqoop(SQL-to-Hadoop)是专门为Hadoop和关系型数据库之间传输数据设计的工具,它擅长处理大规模数据的全量或增量同步,具备自动并行化、断点续传和类型自动映射等优势。
- 适用场景:每日定时同步千万级以上的宽表数据,或者需要高吞吐量的ETL流程。
- 核心优势:支持增量导入(Incremental Import),可基于时间戳或自增ID只同步新增数据,极大减轻数据库压力。
- 操作路径:通常通过命令行调用,
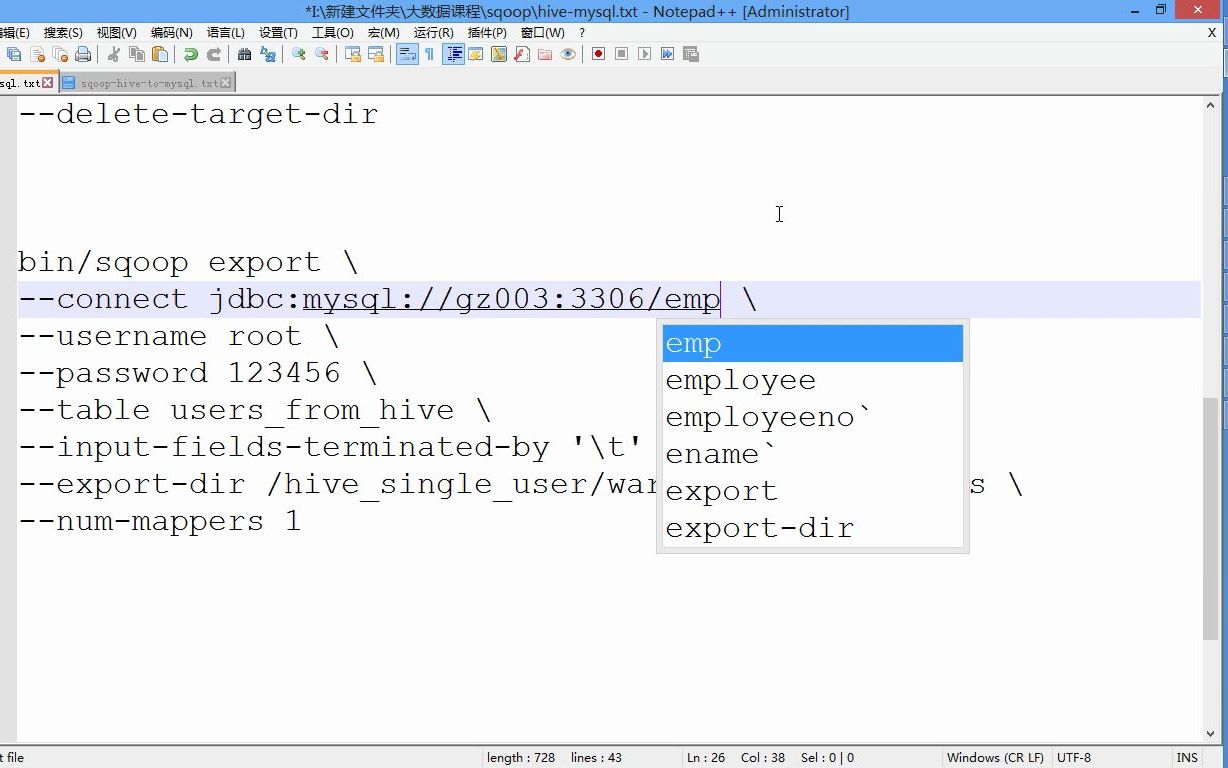
sqoop export --connect jdbc:mysql://host/db --table target_table --export-dir /path/to/hive/data。
Hive JDBC Output:轻量级灵活方案
对于小规模数据或对依赖包敏感的环境,Hive原生支持的JDBC输出格式更为便捷,它允许用户在HiveQL中直接指定输出格式为JDBC,无需安装额外的Sqoop服务。
- 适用场景:小批量数据推送、临时性数据验证、或无法部署Sqoop集群的轻量级环境。
- 核心优势:配置简单,无需额外服务,直接集成在Hive SQL中。
- 局限性:并发处理能力较弱,大数据量下容易成为性能瓶颈,且缺乏增量同步的高级特性。

实操步骤:基于Sqoop的数据导出全流程
对于大多数企业级应用,Sqoop是更稳健的选择,以下是将Hive表数据导出至MySQL的具体操作指南。
环境准备与依赖检查
在执行导出前,必须确保Hadoop集群和MySQL数据库之间的网络连通性,并准备好必要的JDBC驱动。
- 安装Sqoop:确保Sqoop已正确安装在Hadoop节点上,并配置好环境变量
SQOOP_HOME。 - 驱动放置:将MySQL的JDBC驱动包(如
mysql-connector-java.jar)复制到Sqoop的lib目录下,这是最常见的报错来源,务必确认版本兼容。 - 权限确认:确保执行Sqoop的用户拥有Hive表的读取权限,以及MySQL目标库的写入权限。
配置连接参数与映射规则
连接字符串和字段映射是导出的核心,Hive中的数据类型与MySQL并非完全一一对应,需要手动调整。
- 连接URL:格式为
jdbc:mysql://<host>:<port>/<database>,若需高可用,可配置多个节点。 - 字段映射:使用
--columns参数指定要导出的列,Hive中的STRING类型在MySQL中通常映射为VARCHAR,BIGINT映射为BIGINT。 - 空值处理:Hive中的
NULL在MySQL中需明确处理,建议在导出前使用COALESCE函数将空值替换为默认值,避免插入失败。
执行导出命令与监控
构建完整的导出命令,并关注执行日志。
sqoop export
--connect "jdbc:mysql://192.168.1.100:3306/business_db"
--username "root"
--password "your_password"
--table "daily_report"
--export-dir "/user/hive/warehouse/daily_report"
--input-fields-terminated-by "01"
--input-lines-terminated-by "n"
-m 4

-m 4:指定4个Map任务并行导出,提升速度,根据数据量调整此参数,过大可能导致MySQL连接数耗尽。--input-fields-terminated-by:指定Hive数据文件中的分隔符,需与Hive表定义一致。
性能优化与常见问题排查
在实际生产中,数据导出往往面临性能瓶颈或数据一致性挑战。
MySQL写入性能瓶颈
MySQL作为行式数据库,在大量并发写入时容易成为瓶颈。
- 关闭索引:在大批量导入前,可暂时禁用目标表的非唯一索引,导入完成后重建,这能显著提升写入速度。
- 事务控制:Sqoop默认每条记录提交一次事务,开销巨大,建议设置
--batch参数,启用批量提交,减少网络往返和事务开销。 - 连接池配置:检查MySQL的
max_connections和wait_timeout设置,防止因连接数过多导致连接拒绝。
数据一致性与完整性
数据从Hive流向MySQL,必须保证不丢不重。
- 增量策略:若使用增量导入,需确保Hive中的时间戳或ID字段单调递增,建议在Hive端增加一个
export_status字段,标记已导出数据的状态。 - 去重机制:在MySQL目标表中设置唯一约束(Unique Key),并配合
INSERT IGNORE或ON DUPLICATE KEY UPDATE语句,防止重复数据插入。
Sqoop与Hive JDBC导出在成本与效率上的对比
选择哪种方案,往往取决于团队的技术栈和维护成本。
| 对比维度 | Sqoop | Hive JDBC Output |
|---|---|---|
| 学习曲线 | 中等,需掌握命令行参数 | 低,仅需SQL知识 |
| 吞吐量 | 高,支持并行和增量 | 低,单线程或低并发 |
| 资源消耗 | 依赖Hadoop MapReduce或YARN | 依赖Hive执行引擎 |
| 维护复杂度 | 需维护Sqoop服务及驱动 | 无额外服务依赖 |
| 适用数据量 | 百万至十亿级 | 万级以下 |

业内共识认为,对于日均数据量超过百万行的场景,Sqoop是更优选择;而对于小规模数据同步,Hive JDBC足以胜任,且能减少运维负担。
常见问题解答:Hive将结果保存至mysql
如何避免Hive导出到MySQL时出现乱码?
乱码通常源于字符集不一致,建议在MySQL建表时明确指定 CHARSET=utf8mb4,并在Sqoop连接URL中添加 ?useUnicode=true&characterEncoding=utf8 参数,确保Hive表的SerDe配置也使用UTF-8编码。
Sqoop导出失败,提示“Too many open files”怎么办?
这通常是操作系统文件描述符限制所致,需要在Hadoop节点和MySQL服务器上调整 ulimit -n 的值,将其设置为更大的数值(如65535),检查Sqoop的 -m 参数,减少并发任务数也能缓解此问题。
增量导出时,如何确保不会漏掉数据?
增量导出依赖于检查列(如 update_time),必须确保该列在Hive中是单调递增的,且在每次导出后,源数据不会被修改,建议在Hive端使用 INSERT OVERWRITE 分区的方式,每次只处理新增分区,而非全表扫描,从而保证数据的完整性和可追溯性。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/452432.html