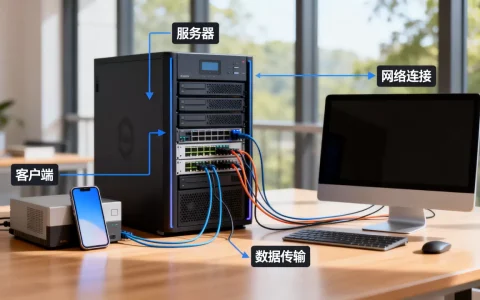
服务端和数据库是任何现代应用都离不开的两大核心组件,服务端负责处理业务逻辑,数据库负责持久化数据,两者协同才能支撑起完整的服务,理解它们的关系和配置方式,是构建稳定高效系统的基础。
服务端和数据库是分开部署还是共存
单体架构下的服务端与数据库
在项目初期,服务端和数据库常常部署在同一台服务器上,这种架构简单,部署成本低,管理方便,但缺点也很明显:当用户量增加时,两者会争抢CPU、内存和磁盘IO,导致性能瓶颈,业内专家指出,这种模式适合用户量不大、预算有限的场景,比如个人博客或内部管理系统。
分离架构的优势与挑战
随着业务增长,将服务端和数据库分离部署是更主流的选择,分离后,它们可以独立扩展,比如数据库单独使用高IOPS存储,服务端增加计算资源,数据库可以放在内网,减少被攻击的风险,但分离架构也带来网络延迟和管理复杂度,据统计,相当一部分企业通过分离架构提升了系统可用性,但也增加了运维工作的复杂性。
如何根据业务场景选择
选择共存还是分离,取决于业务规模、团队能力和预算,如果用户量预期增长较快,或者需要高可用性,分离架构是明确方向,如果只是小项目或原型验证,共存可以快速启动,越来越多团队选择云数据库托管服务,如简米云RDS、酷番云CDB,这些服务自带备份、主从切换,进一步降低了分离部署的运维门槛,这里涉及“服务端和数据库价格”的考量,云服务虽然初期费用低,但长期使用需要根据实际流量评估,避免成本失控。
服务端和数据库怎么连接才安全高效
常用连接方式:直连、连接池、ORM
服务端和数据库的连接方式有多种,直连简单但效率低,不适合高并发,连接池技术预先创建并复用连接,是高性能应用的标配,在Java中使用HikariCP,配置
maximumPoolSize为10-20,根据并发量调整,ORM框架如SQLAlchemy、Hibernate则进一步简化开发,但要注意ORM可能产生低效SQL,需要监控。
连接安全配置:加密、认证、防火墙
连接安全至关重要,服务端应使用SSL/TLS加密连接数据库,防止数据被窃听,在MySQL中,配置require_secure_transport=ON,数据库用户应使用强密码,并限制仅允许应用服务器IP连接,在Linux上,可以使用iptables限制数据库端口访问,命令如下:iptables -A INPUT -p tcp -s 应用服务器IP --dport 3306 -j ACCEPT,然后拒绝其他IP,定期更新数据库版本和补丁,也是安全的重要环节。
连接优化策略:减少延迟、复用连接
为了减少网络延迟,服务端和数据库应尽量部署在同一区域,比如同一数据中心,如果使用云服务,选择同一可用区,连接复用通过连接池实现,避免频繁创建连接的开销,设置合理的连接超时时间,比如wait_timeout为28800秒,并定期检测空闲连接,防止连接泄漏,使用netstat -an | grep 3306可以监控当前连接数。
服务端和数据库的协同优化
查询优化与索引设计
数据库查询效率直接影响服务端响应速度,合理设计索引,避免全表扫描,是首要优化手段,使用EXPLAIN分析SQL执行计划,查看是否使用了索引,对于频繁查询的字段,添加索引,但也要注意,索引过多会影响写入性能,需权衡,行业共识认为,大多数数据库性能问题都源于不合理的查询和索引设计,定期分析慢查询日志是必要的。
缓存策略减轻数据库压力
服务端可以使用缓存层,如Redis、Memcached,将热点数据缓存起来,减少数据库直接查询,常见策略是读缓存:先查缓存,未命中再查数据库,并写入缓存,设置过期时间,在Redis中,使用
EXPIRE key 3600设置缓存1小时过期,对于写操作,可以采取先更新数据库,再删除缓存的方式,保证最终一致性,缓存能显著提升高并发场景下的响应速度,但要注意缓存雪崩和穿透,可以设计缓存预热和布隆过滤。
数据一致性保障
在分布式系统中,服务端和数据库之间保持数据一致性是挑战,事务可以保证原子性,但在高并发下会锁定资源,影响性能,有时需要采用最终一致性方案,比如使用消息队列异步同步数据,或者通过补偿机制处理失败,具体选择取决于业务对一致性的要求,比如金融系统要求强一致性,而社交动态可以接受短暂不一致。
服务端和数据库选型建议
关系型数据库 vs NoSQL
服务端对接的数据库类型多样,关系型数据库如MySQL、PostgreSQL,适合结构化数据,支持事务和复杂关联查询,NoSQL如MongoDB、Redis,适合灵活数据模型和高性能读写,选型时考虑数据特点:如果数据关系紧密,事务要求高,选关系型;如果数据模式多变,读写量大,选NoSQL,电子商务系统的订单数据适合关系型,而用户行为日志适合NoSQL。
| 类型 | 适用场景 | 数据一致性 | 扩展性 |
|---|---|---|---|
| 关系型数据库 | 订单、用户 | 强 | 垂直扩展为主 |
| NoSQL | 日志、缓存 | 最终 | 水平扩展 |
服务端框架与数据库的兼容性
不同服务端技术栈对数据库的支持不同,Node.js常使用Mongoose连接MongoDB,Python的Django默认使用ORM连接关系型数据库,Java的Spring Boot支持多种数据源切换,选型时应考虑框架的生态、社区活跃度以及团队熟悉的技术栈,如果你的团队熟悉Java,选择Spring Boot+MySQL是稳妥的组合。
云服务托管 vs 自建
对于数据库,可以选择自建服务器,也可以使用云数据库服务,云服务提供自动备份、监控告警、弹性扩展,但价格相对较高,自建则需要专人维护,但成本可控,尤其适合大规模流量,这里,“服务端和数据库价格”的因素需要综合评估:初期选择云托管可以快速上线,后期可以根据流量增长,比较自建与云服务的成本差异,国内企业普遍采用混合方案,核心业务自建,一般业务上云。
服务端和数据库的配合是系统设计的核心,理解它们的分工、连接方式和优化方向,能帮助你构建更稳定、高效的应用,无论是选择共存还是分离,都要基于业务需求做出合理决策,并在实践中持续优化。
Q&A
服务端和数据库分开部署会影响性能吗?
分离部署会增加一次网络跳转,但通过连接池优化和部署在同一区域,延迟影响很小,而且分离后,两者可以独立扩展,整体性能反而提升,对于业务增长阶段的应用,分离部署是更合理的长期方案。
服务端和数据库连接超时怎么办?
连接超时通常由网络问题、数据库负载过高或连接池耗尽导致,可以先检查网络连通性,比如使用ping或telnet测试端口,然后查看数据库的max_connections是否合适,以及应用连接池是否需要调大,优化后,可以调整连接超时时间,比如在MySQL设置connect_timeout=10,使用监控工具跟踪连接状态。
服务端和数据库选型时需要注意什么?
选型要综合考虑数据一致性、读写比例、团队技术栈和预算,关系型数据库适合事务性强的业务,NoSQL适合灵活扩展的场景,评估云服务与自建的成本差异,确定符合业务阶段的选择,没有绝对最优,只有最适合。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/511125.html