CG高复杂场景的显存规划没有万能公式,核心答案是:先判断渲染路径,再按“几何体、纹理、渲染缓存”三层拆解预算,最后用分块加载和代理模型把峰值压力削平。很多从业者把显存不够归咎于显卡不行,但真实瓶颈往往出在资源加载策略上,下面这套规划方法,适用于影视级场景、建筑可视化以及高细节产品渲染,能让你在现有硬件上多塞一倍的场景内容。
显存爆掉的真实原因:不仅是容量小
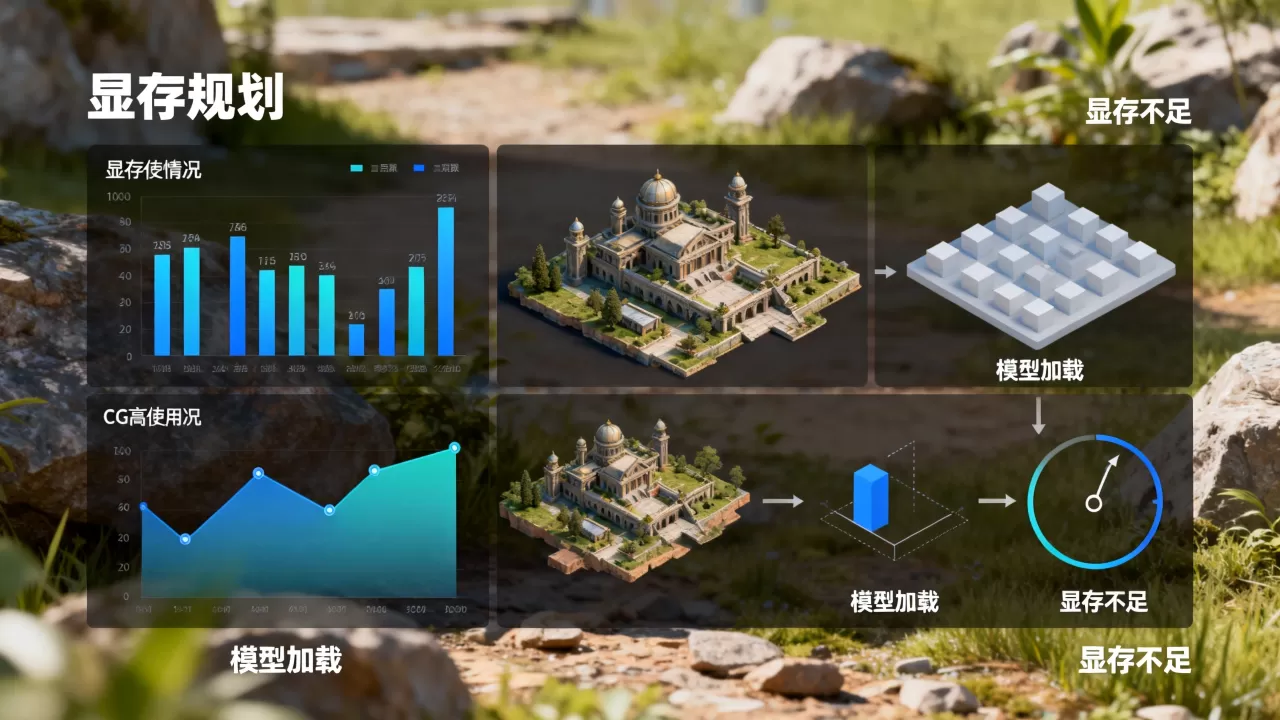
模型加载瞬间的“显存尖峰”是罪魁祸首
行业内讨论显存不足时,多数情况指的不是场景持续占用的平均值,而是加载瞬间的瞬时峰值,GPU需要同时处理几何数据上传、纹理解压、着色器编译和光照烘焙,这些任务并行时,显存需求会陡然上升到稳态值的1.5倍以上,这就是为什么你看到任务管理器里显存明明够用,一加载复杂场景就报错。


三层资源各自占了多少“地”
- 几何数据层:高模场景的上百万面片,每顶点位置、法线、UV信息会占据基础显存,一个1000万面的场景,仅几何缓存就可能吃掉3-4GB显存(据行业软件实测平均值)。
- 纹理层:4K甚至8K的PBR纹理是最贪婪的显存消耗者,一张4K的RGBA贴图占显存约64MB,而一个包含颜色、法线、粗糙度、金属度、AO的五张贴图组,就超过320MB,30个这样的材质球立刻破10GB。
- 渲染缓存层:包含了深度缓冲、G-Buffer、光照贴图、阴影贴图和降噪缓存,4K分辨率下,这一层固定开销普遍在2-3GB,路径追踪渲染器还会额外增加辐射度缓存。
不同渲染路径下的显存规划差异
GPU光栅化渲染:控制对象数量
在Unreal Engine或Twinmotion这类实时引擎里,模型加载的显存规划主要靠LOD(多层次细节)和实例化,操作路径是:选中模型,在细节面板把LODAuto设置打开,引擎会自动按距离切换减面模型,以一座包含500栋建筑的城市场景为例,开启Nanite虚拟化几何后,显存占用能压缩到传统方式的四分之一,用Maya或Blender导出模型时,记得勾选GPU Instancing选项,相同物体只存储一份数据。
离线渲染(路径追踪):纹理压缩比几何更重要
V-Ray、Octane、Redshift这类渲染器的显存规划逻辑完全不同。多数情况下,材质贴图占了80%以上的显存开销,几何反而可以通过网格细分动态生成,做室内效果图时,一套完整的4K材质库用完就卸载是关键,以Octane为例,在Kernel设置里启用Out-of-Core纹理缓存,把系统内存当作显存溢出缓冲区,显示多少内存合适,并无统一定论,但行业经验值建议至少64GB物理内存。
显存不够怎么办?先尝试这三个操作
- 关掉视口里的景深和屏幕空间反射,这两个后期效果单独就能吃500MB以上显存。
- 使用纹理降级插件(如TextureManifest)批量把5K贴图转为2K,项目要求近景特写的地面单独保留原始分辨率。
- 把场景拆成前后两半,用摄像机距离触发Hide和Show蓝图节点,远景部分深度隐藏不载入显存。
纹理资源的“精算级”分配策略
4K材质显存占用对比
| 纹理类型 | 单张显存占用(近似值) | 复杂场景中建议使用量 |
|---|---|---|
| 8K RGBA | 256MB | 不超过3张 |
| 4K RGBA | 64MB | 主要资产专用 |
| 2K RGBA | 16MB | 次要道具、墙面 |
| 1K 灰阶贴图 | 4MB | 批量小物体 |
做建筑外观可视化时,外墙材质值得用4K,而内部家具这类次要元素用2K足够了,行业共识是,肉眼在1:1视图下分辨2K和4K的差异需要近距离观察,静态帧出图偶尔差异明显,但动画中差异极小。核心原则是贴图分辨率跟着摄像机停留时长走,特写长镜头用高分辨率,扫视快速镜头用低分辨率。
纹理压缩节省的显存超出预期
启用BC7格式压缩能大幅降低显存压力,Blender用户可在导出纹理时将色彩贴图转为BC7格式,法线贴图用BC5,单张4K纹理可压缩到原来的25%,前提是项目不使用某些无法直接读取压缩纹理的老版本渲染器,从实际操作看,一个用掉127GB显存的巨大场景,经过压缩和尺寸分级后,降到符合48GB工作站的规格是有可能的。
模型加载顺序和缓存策略同样关键
显存释放的“冷热分层”
规划显存要像管理内存一样区分热数据和冷数据,进入摄像机组A覆盖的范围时,加载资源A;当视角切到B区域,需要主动释放A的显存,再加载B,这个逻辑在Unity里用Addressable资源系统实现,在虚幻引擎里用Level Streaming实现,有个容易忽略的细节:释放纹理显存必须调用Clear命令清空缓存,而不仅是取消引用对象,否则VRAM依然被占着。
代理模型策略
对于万级数量的物件(如森林、植被、石块),使用Point Cloud或Sprite代理可以避免显存不堪重负,在SpeedTree中,树的远景LOD直接替换成卡片面片,一个面片只用几百KB显存,当摄像机拉近到设定距离时再切换成完整模型,近年来的硬件性能提升幅度很大,但CG资产增长速度更快,代理策略仍属主流方案。
渲染农场的显存规划与价格考量
渲染农场显存价格怎么算更合理
独立制作人或小工作室在本地配置高显存工作站成本较高,因此更倾向于将重资产项目提交到云渲染农场。在渲染农场显存价格区间里,48GB规格的机器性价比相对突出,足以应对多数建筑漫游和产品动画,而96GB以上机器的单价上涨幅度同显存增长并非线性关系,只适用于极端复杂的特效镜头。
本地工作站显存配置的务实参考
- 入门级(24GB):适合单个中等复杂度的场景,少量8K纹理,用LOD保持面片数在500万以内。
- 进阶级(48GB):适合室外建筑+周边环境,这片配置能兼顾视口交互和最终帧渲染。
- 专业级(96GB以上):适合数字人扫模、高精度工业零件,或者需要一版渲染内包含大量独立动态物体。
提交流程上,多数农场支持上传源文件后自动检测场景复杂度并分配机器,注意栈帧动画序列记得勾选检查点保存,以防某帧显存出错导致全片重渲。
文生图与AI辅助生成中的显存规划差异
AI辅助流程对显存提出了新的需求
文生图、图生视频这类高质量工作流和纯3D渲染存在本质区别AI模型本身要占据显存,你不可能把所有VRAM都留给场景,在ComfyUI里跑SDXL模型加ControlNet和IPAdapter,显存占用经常突破16GB,用4K超分模型再放大一遍,还会多出按输入分辨率大小倍增的临时显存。
规划上建议单独分割作业组,在加载“高细节机械模型”这类长尾任务时,关闭背景图层,保持模型上下左右留白仅需占屏幕面积的一半,避免无关像素挤占显存带宽,如果既要跑AI又要加载大型场景,只靠单卡切换是可行的,但看着不够从容,两台机器各干一档更稳定高效。
实操排查路径总结:从报错到定位
如果你遇到“显存不足”或“CUDA Out of Memory”报错,按下面的顺序逐层排查,比盲目换卡有效得多:
- 第一步:打开GPU-Z监测显存占用曲线,确认是加载瞬间峰值过高还是持续占用过高。
- 第二步:逐个关掉材质球测试单一物体,定位显存大头,重点注意字符纹理、细节较高的置换贴图和雕刻细节模型。
- 第三步:把总场景按半透明和实体分为两组,隐藏半透明物体后重测,不少大场景的显存是被Blend模式材质拖垮的。
- 第四步:增加虚拟内存,显存不足且物理内存充裕时,部分渲染器能借用系统内存继续运作,代价是渲染时间明显变长,按帧预估时间会有30%到数倍的增加。
Q&A:显存规划中最常被问到的三个问题
显存规划是买大显存显卡一劳永逸吗
不是,实际工作中,离线渲染场景往往比显卡显存更早触及物理极限,显存规划的核心是控制和复用,大小合理的显存配合合理的资源流式加载,投放精力和效果都更稳定,超大显存容易让人忽视优化,反而导致项目管线越来越粗糙。
同一个场景在Windows和Linux下的显存表现一致吗
不同驱动和渲染器的影响主要体现在运行稳定性层面,比如CUDA资源释放机制存在差异,Linux下驱动崩溃恢复机制运行更平滑,基础显存预算差异较小,通常可以按照同一套数据标准规划。
显存规划应该在建模阶段还是后期材质阶段介入
越早越好,最迟在奠基模型、制作白模之前就定下纹理尺寸级别和显存分层方案,如果等到材质做完再考虑压缩,往往要返工重做带有UV的导出资源,返工成本几乎成倍增长,提前规划虽然麻烦,但后续边际收益极高,行业里有经验的组长默认都会在项目启动时把显存预算表发到团队共享文档里。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/701303.html