TCP服务器保证两个包不混,靠的是应用层协议里的报文边界定义TCP本身只提供有序字节流,不负责消息边界。 换句话说,如果两个业务数据包在发送时没有约定“包从哪里开始、到哪里结束”,接收端就会把它们当成连续的水流,混在一起,要想不混,必须自己动手给每条消息穿上“马甲”,让服务器能一眼认出来。
TCP为什么会出现两个包混在一起?
TCP是面向字节流的协议,应用层把数据写进socket,TCP会按自己的节奏分割成若干报文段,接收端再把收到的字节按顺序拼起来,这个过程中,两个不同业务包的字节可能连着到达,接收方如果一次读取了过多字节,就会把第一个包的尾部加上第二个包的头部,形成粘包,反过来,一个业务包可能被拆成多个TCP段,接收方只读到一部分,就形成半包。
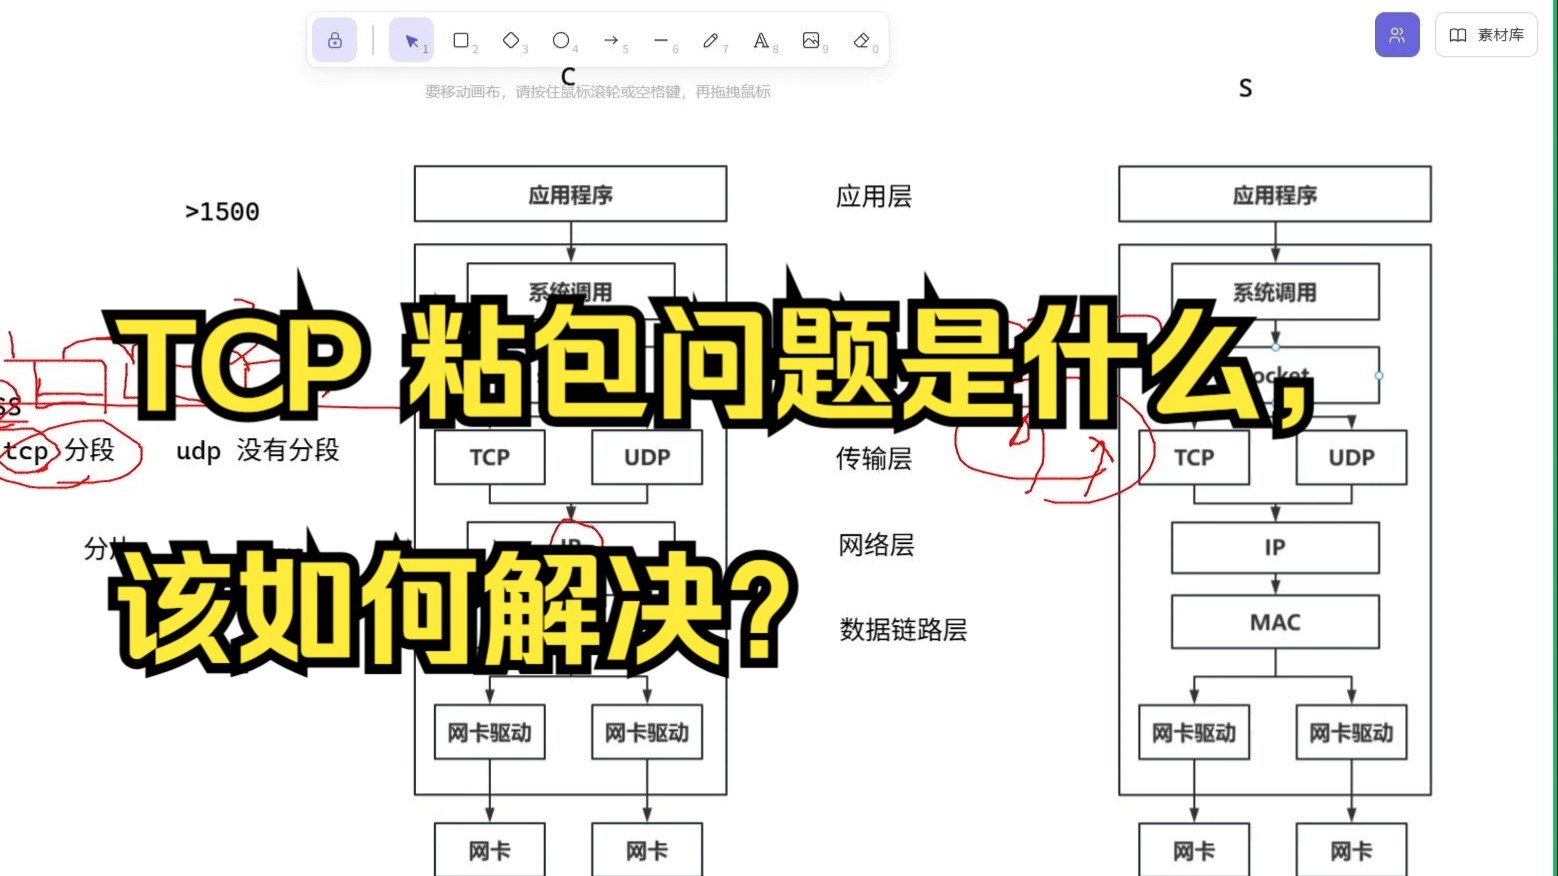

业内专家指出:粘包和半包不是TCP的bug,而是消息边界缺失的自然结果,UDP没有这个问题,因为它每个udp报文自带边界,读一次就是完整数据报,TCP的数据流更像一根连续的水管,水分子之间没有“隔断”,你需要自己安装阀门。
常见的坏习惯:不做协议设计
很多新手在写TCP服务器时,直接发送结构体或字符串,接收端用recv一读就完事,短连接下可能碰巧不混,一旦进入长连接或者高并发场景,问题立刻爆发,这属于传输协议设计不完善,而不是框架的锅。
为什么要分清“包”和“报文”
“包”在TCP层面是报文段,在网络层是IP分组,我们讨论的“两个包不混”,指的是应用层消息,TCP保证的是字节顺序不变,但不保证每次写入的数据块读出来时还保持原样,所以应用层必须自己定义“消息边界”。
tcp粘包怎么解决?常用方案拆解
解决方案本质是:在发送端和接收端约定一个“包装格式”,常见有三种,各有适用场景。
固定长度消息
每个消息固定为N字节,不足时补零,读取时按长度截断,好处是解析简单,坏处是浪费带宽,适合小包、高频控制的场景,比如心跳包、传感器数据。
分隔符分割
用特殊字符或字符串作为边界,比如n或rn,接收端边读边扫描,遇到分隔符就认为一条消息结束,适合文本协议,比如HTTP头部就用了
rnrn,坏处是消息里不能出现分隔符,否则需要转义,而且需要边读边缓冲,半包处理麻烦。
长度字段自定义协议
这是最主流、最推荐的方式,每个消息由“协议头+内容”组成,协议头里至少包含总长度字段,接收端先读固定长度的协议头,再根据长度字段读取剩余内容,典型格式:
- 2字节或4字节无符号整数表示消息总长度(或内容长度)数据
- 顺序固定,两端一致
实操设计步骤
- 定义结构体,比如
int32_t len + char body[],len= body的长度 + 头部长度。 - 发送端填充len,然后一次性
send。 - 接收端循环读取,先读进缓冲区的头4字节,用
ntohl转为整型。 - 检查len是否在合理范围(比如最大不超过10MB,防止恶意错值)。
- 继续读
len个字节,拼接成完整消息。 - 处理完一条,继续读下一条。
这样每一条消息都有明确终点,永远不会混,核心要点是:接收端必须处理半包,因为一次recv可能只读到部分消息。
tcp 分包 拆包 原理:从字节流到完整消息
理解了协议设计,再看底层原理,TCP不会告诉你“这两组字节来自同一个send”,它只保证按序可靠传输,因此接收端的缓冲区就是一个可连续追加的字节数组,你需要自己维护“当前累计读了多少字节、目标长度是多少”。
用状态机管理数据流
推荐的做法是维护三个变量:
buffer:动态增长的字节数组pos:当前已解析位置expectedLen:当前消息期望的总长度
解析流程类似这样:
- 从socket读入新数据,追加到buffer尾部。
- 检查buffer中剩余字节数是否足够
expectedLen。 - 不够,继续等待下一次读事件。
- 够,则从buffer中截取出一条完整消息,更新pos。
- 如果buffer还有多余字节,说明下一条消息已经到达,继续循环解析。
这就是tcp 分包 拆包 原理的落地实现,很多高性能框架如Netty、Boost.Asio、libevent都内置了拆包器,但底层思路完全一致。
缓冲区设计避免复制开销
频繁把字节从临时数组拷贝到应用缓冲区,在高并发下很浪费CPU,业内共识认为,好的拆包器应该直接使用“可消费索引”和“可写索引”,把未解析的数据留在原地,只移动指针,比如Netty的ByteBuf就采用writerIndex和readerIndex,既能避免拷贝,又能支持零拷贝处理。
遇到畸形数据怎么办
如果长度字段异常,会导致缓冲区等待一个永远无法满足的长度,所以必须设置最大包长,一旦超过预设值,直接断开连接,防止恶意客户端占用内存。行业共识认为,安全性和解析效率同样重要。
实战:tcp服务器 并发 性能 如何兼顾拆包效率
拆包逻辑写得再好,服务器整体性能不行同样白搭,需要考虑线程模型、IO模型、业务处理速度三者匹配。
线程模型选择
- 单线程Reactor:适合简单业务,拆包和逻辑串行,延迟低,但无法利用多核。
- 多线程Reactor:主线程负责accept,工作线程处理IO事件,每个连接绑定固定线程,避免锁竞争。
- 主从Reactor + 线程池:Netty默认模式,读写在IO线程,业务逻辑扔给业务线程池,适合高并发场景。
拆包和业务处理分离
不要把业务处理放在拆包线程里,拆包线程只负责从缓冲区切出一条完整消息,然后放入队列,业务线程组从队列取消息处理,这样拆包阻塞不会影响网络读取,也能通过队列调节瞬时峰值。
性能相关配置要点
- 接收缓冲区大小要动态调整,避免频繁扩容。
- 使用内存池缓存消息对象,避免每条消息都new。
- 对于小包,可以批量读取、批量解析,减少系统调用。
- 开启TCP_NODELAY禁用Nagle算法,降低小包延迟。
tcp服务器 并发 性能问题往往不是单一原因,而是协议设计、IO模型、业务耗时、内存分配等多因素叠加,先用压测工具跑出瓶颈,再针对性优化。
tcp 长连接 短连接 区别:哪个更适合你的场景
拆包协议在长短连接下都有作用,但长连接中粘包问题更突出,因为短连接发送完就断开,边界天然存在关闭socket会让对端读到EOF,长连接则不同,字节持续流动,必须依赖协议头。
对比表
| 维度 | 短连接 | 长连接 |
|---|---|---|
| 连接建立开销 | 每次都有TCP握手 | 只需一次握手 |
| 消息边界 | 靠EOF也可,但无法批量发送 | 必须自定边界 |
| 适用场景 | 低频、一次一问一答 | 高频、推拉结合、实时通信 |
| 服务端资源 | 占用少但握手成本高 | 占用fd多、需心跳维护 |
| 服务端实现复杂度 | 简单 | 需要连接管理、定时清理 |
如何选择
如果你的服务器每次请求就一个包,且频率很低,比如短信发送接口,短连接足够,如果是一台TCP服务器需要同时服务大量客户端,且消息频繁交互,比如游戏服务器、聊天服务器、物联网数据采集器,必须使用长连接,并配合标准拆包协议。
短连接防粘包确实简单,但代价是TCP握手SYN洪泛风险,以及每次握手延迟,行业共识认为,面向高并发场景,长连接是前提;面向极简RPC调用,短连接减少维护成本,选择取决于业务吞吐量和对实时性的要求。
关于tcp服务器 拆包 粘包 的常见问题
如果消息里包含长度字段的值,但发送时被拆成两个TCP段,服务器怎么处理?
服务器只需把第一次读到的字节存入缓冲区,发现还没凑够长度字段要求的字节数,就继续等待下一次读事件,下一次读到剩余字节后,再拼成完整消息,这就是半包处理的核心思路,和粘包处理共用同一套缓冲区逻辑。
分隔符方案和长度字段方案哪个更稳?
长度字段方案更稳,分隔符方案需要扫描每个字节,而且要求消息内容不能包含相同分隔符,否则必须加转义,长度字段方案只需读固定字节数,定位准确,处理效率更高,对于二进制协议,长度字段是行业默认选择。
客户端是第三方硬件,不支持自定义协议头,该怎么办?
如果硬件只输出固定格式的文本,比如以换行结尾,那只能使用分隔符方案,如果连分隔符都没有,但报文长度固定,那就使用固定长度方案,如果既无定长也不带分隔符,只能根据时间间隔猜这很不安全,不建议在正式环境使用,最可靠的路径还是让硬件提供固件修改支持,或者增加协议转换网关。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/728636.html