工程仿真服务器不是“CPU核多就行”的通用机型,它的核心是让内存带宽、核数、互联和存储IO匹配你用的求解器,选错方向多花的钱基本等于白花。一句话概括:先看软件和模型规模,再定CPU平台与内存配比,最后用网络和存储补短板。
工程仿真服务器和普通服务器到底有什么区别
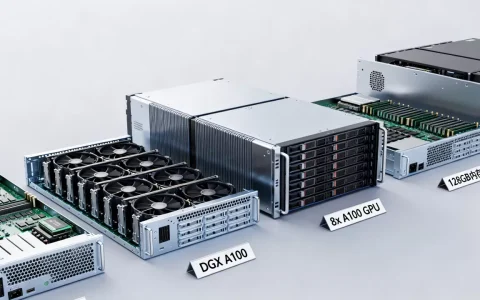
很多人拿一台通用双路机架服务器跑ANSYS,结果发现核数加了、速度不涨,问题就出在“通用”两个字上,工程仿真属于典型的HPC负载,它跟Web、数据库、虚拟化那类服务器的取向几乎相反。
三个真实差异,决定钱花在哪
- 吃内存带宽,不只是吃容量。 隐式结构求解、CFD压力求解器大量做稀疏矩阵运算,性能瓶颈常在内存带宽,双路平台通常有8通道或12通道,内存条没插满、没按通道均衡插,带宽直接砍半,这也是为什么有些机器“看着配置不低,跑起来不如老机器”。
- 核数有甜蜜点,不是越多越好。 受NUMA和MPI通信开销影响,单节点并发核数存在收益拐点,多数情况下,隐式求解在单节点32至64核区间性价比最好;显式求解(如碰撞、跌落类)扩展性更好,能吃到更多核。
- 互联和存储是隐形天花板。 跨节点并行靠MPI通信,千兆网跑多节点并行基本等于自废武功,需要InfiniBand或RoCE这类低延迟网络,求解过程中产生的大量临时文件,没有NVMe做scratch盘,会明显拖慢整体节奏。
| 对比项 | 通用业务服务器 | 工程仿真服务器 |
|---|---|---|
| CPU取向 | 高频、中等核数 | 高核数、支持AVX-512等向量指令 |
| 内存 | 容量优先,通道随意 | 容量与带宽并重,必须插满通道 |
| 网络 | 万兆够用 | 多节点需IB/RoCE低延迟互联 |
| 存储 | SATA/SAS容量盘 | NVMe做临时盘,容量盘做归档 |
| 显卡 | 可选 | CFD后处理、GPU求解器按需配置 |
工程仿真服务器怎么配置,按软件和模型规模分场景说
脱离软件谈配置没有意义,下面按最常见的几类求解场景给方向,具体核数与内存仍需结合模型网格量测算。
结构隐式求解:ANSYS Mechanical、Abaqus Standard
这类求解器依赖直接法稀疏求解,内存消耗随自由度增长很快,且对内存带宽敏感。
- 内存容量按“每核4至8GB”起步预留,大模型直接按总自由度估算,宁多勿少,内存不足时求解器会退到硬盘,速度断崖式下跌。
- 优先选高主频、支持大容量内存的双路平台,单节点控制在32至64核,避免NUMA跨节点访问拖累。
- 硬盘至少留出一块NVMe给求解临时目录,路径在求解器设置里显式指定,不要用系统盘。
流体CFD:Fluent、STAR-CCM+
CFD对内存带宽和互联更敏感,网格量是核心变量。
- 经验做法是按每百万网格预留1GB左右内存打底,再乘上物理模型复杂度系数,多相、燃烧、动网格要往上加。
- 多节点并行时,优先保证互联质量,节点数增加前先确认单节点扩展效率,很多案例里4节点跑不过2节点的原因就在通信开销。
- 后处理吃显存,如果需要大量云图、流线渲染,配一张专业卡比堆CPU更划算。
显式与多物理场:LS-DYNA、COMSOL
显式求解并行效率高,适合堆核;COMSOL的多物理场耦合则更看重内存容量和求解器类型选择。
- 显式场景可以放心上高核数平台,单节点64至128核都有实际收益。
- COMSOL建议在软件内切换迭代求解器并调优预条件,硬件堆料之前先把求解器设置调对,收益往往比加内存更直接。
GPU到底能帮多少忙
行业共识认为,GPU加速目前在CFD部分求解器、AI辅助代理模型、后处理渲染上收益明确,但传统隐式结构求解仍以CPU为主,预算有限时,先把CPU平台和内存通道做扎实,再考虑加卡。
工程仿真服务器多少钱一台,预算怎么分配才不浪费
价格跨度极大,从几万元的单机工作站到上百万元的多节点集群都有,关键是把钱按瓶颈排序花。
按规模分三档看
- 单机工作站档(几万元级):塔式或静音机箱,适合中小模型、前后处理为主,CPU选主流高主频型号,内存插满通道,加一块NVMe。
- 部门级单机/双机档(十几万至几十万元级):双路高核数机架服务器,大容量内存插满通道,配NVMe阵列,适合常规CFD与结构求解。
- 集群档(数十万元以上):计算节点加管理节点、IB交换机、并行存储,配套Slurm或PBS类作业调度,适合多用户共享和超大模型。
容易漏算的隐性成本
- 商业License:HPC并行许可按核或按任务计费,核数翻倍可能带来许可成本翻倍,这笔钱常常超过硬件本身。
- 存储与备份:结果文件动辄几十上百GB,归档存储和备份策略要提前规划。
- 机房条件:高核数机器的功耗和散热不可忽视,机架承重、供电、风冷或液冷都要在采购前确认。
国内工程仿真服务器品牌与部署方式怎么选
自建还是上云,是采购前必须回答的问题。
自建与云端的取舍
- 长期高频使用、数据敏感、模型规模稳定,自建更划算,硬件折旧周期内单位算力成本更低。
- 项目制、峰值波动大、需要临时扩容,云端按需付费更灵活,但要算清数据传输和License携带成本。
- 混合模式也常见:日常小模型本地跑,大模型临时租用云端节点。
选型与验收的可操作清单
采购前让供应商提供实测数据,而不是只看参数表,验收时至少做这几件事:
- 用
lscpu确认物理核数、主频和NUMA节点分布,别把超线程逻辑核当物理核算。 - 用
numactl -H检查内存通道是否插满、各节点容量是否均衡。 - 用STREAM类工具测实际内存带宽,与理论值对比。
- 跑一轮目标软件的真实模型,记录单节点不同核数下的加速比,找到性价比拐点。
- 多节点场景用
ibstat确认IB链路速率,再用MPI测试跨节点带宽和延迟。 - 检查scratch盘顺序写性能,确认求解临时目录已指向NVMe。
国内服务器品牌在通用双路平台上的产品线已经比较成熟,选型重点应放在厂商能否提供HPC场景的调优支持和实测报告,而不是单纯比价格。
上线之后怎么验证与调优
机器到位不等于跑得快,几项基础调优能带来可观收益。
- 在Linux下用
numactl --interleave=all或绑定NUMA节点运行求解器,避免跨节点内存访问。 - MPI环境用
mpirun --bind-to core -np 32这类参数绑定核,减少进程迁移。 - 作业调度用Slurm时,在提交脚本里写明
#SBATCH --ntasks-per-node与内存请求,避免多用户互相抢占。 - 定期用
free -g和dstat观察求解过程中的内存与IO峰值,判断是否需要扩内存或换盘。
据行业公开资料,相当一部分仿真项目的时间损耗并非来自硬件不足,而是环境配置与求解器参数未调优,业内专家指出,采购前先做一轮真实模型的基准测试,比事后追加硬件更省钱。
工程仿真服务器的本质是“为求解器定制的算力载体”,把内存通道插满、核数选在扩展拐点、互联和存储补齐短板,这三件事做到位,预算的边际效益最高。
关于工程仿真服务器的常见问题
问:ANSYS仿真服务器配置要求高吗,一台机器能同时跑结构和流体吗?
可以,但要做资源隔离,结构隐式求解吃内存容量,CFD吃内存带宽和互联,同一台机器上建议通过作业调度限定各任务的核数与内存上限,避免互相抢资源,单机通用配置建议内存按最大单任务需求上浮一档预留。
问:工程仿真服务器和普通服务器区别大吗,能不能用现有业务服务器改造?
差异主要在内存通道、互联和存储,业务服务器往往内存没插满、网络是万兆、盘是SATA,直接拿来跑多节点并行会明显受限,单机小模型可以临时顶用,但要做通道均衡检查,并把临时目录换到NVMe上。
问:小团队预算有限,先加内存还是先加CPU核数?
先用目标模型做核数扩展测试,多数情况下,如果内存通道未插满,补内存带来的带宽提升比加核更直接;当核数已接近扩展拐点、内存也插满时,再考虑增加节点并通过低延迟网络互联。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/788643.html