四种主流形态
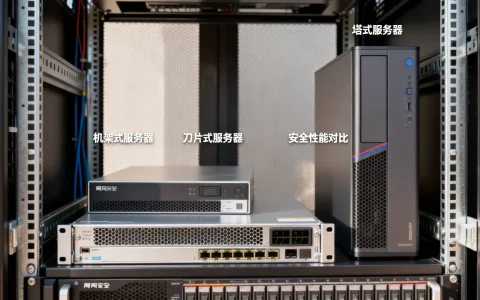
服务器集群技术并不是某一项孤立的软件或硬件,而是一套将多台服务器组合起来、对外呈现为单一计算能力的完整体系。 从用途和架构上划分,目前主流形态分为高可用集群、负载均衡集群、高性能计算集群和存储集群四种,理解这四者的区别,是选型的第一步。
按用途划分的集群形态
- 高可用集群(HA Cluster):核心目标是不间断服务,当一台服务器宕机,另一台自动接管业务,用户几乎感知不到故障发生。
- 负载均衡集群(LB Cluster):核心目标是将海量请求分散到多台服务器上,分摊压力,业务量增长时,加机器就能扛住,也就是常说的横向扩展。
- 高性能计算集群(HPC):核心目标是把一个大任务拆成无数个小任务,分发给集群内所有节点并行计算,最后汇总结果,常用于科研模拟、基因测序、影视渲染。
- 存储集群:提供统一的存储资源池,解决单台服务器硬盘容量和吞吐量有限的问题,常与其他集群配合使用。
行业共识认为,不少大型互联网企业极少单独只使用一种集群方案,常见情况是:高可用集群在前端保障入口稳定,负载均衡集群在中间层分发流量,后端搭配分布式存储集群保存数据。 这三层协同配合,才构成完整的服务器集群技术全景。

高可用集群和负载均衡集群有什么本质区别
很多用户在搜索“高可用集群和负载均衡集群区别”时,其实最困惑的是:两者都用多台服务器对外提供同一个服务,到底哪里不一样?这里用具体场景解释。
二者的核心逻辑差异
高可用集群关心的是“不出事”。 它采用的是主备或双活模式,主备模式里,一台主节点处理所有请求,备节点在旁等待,主节点故障后,备节点通过心跳检测发现异常,迅速抢夺虚拟IP地址并启动服务,整个过程对用户透明。
负载均衡集群关心的是“干得动”。 它前面通常挂一台分发器(调度器),后面是真实的Web服务器集群,所有请求先到分发器,由调度算法决定把请求转发给哪台真实服务器。
用一个具体例子区分:假设这是一家餐厅,高可用集群相当于一个后勤团队,如果主厨师病倒,副厨师立刻顶上,保证厨房一直在运转;负载均衡集群相当于大厅里设了多个取餐窗口,顾客从不同窗口快速拿走自己的餐,而不是排队堵在同一个窗口。
技术实现和部署要点
高可用集群的部署重点是配置心跳线和虚拟IP,心跳线可以是直连网线或者网络心跳,目的是让节点间互相同步健康状态,需要注意“脑裂”问题两个节点同时认为对方已死,都抢占虚拟IP,导致服务冲突,解决脑裂通常采用“多数派”机制,即只有持有票数过半的节点才能成为主节点。
负载均衡集群的部署重点是调度策略的选择,常见策略有轮询(Round Robin)、加权轮询、最小连接数、IP哈希等,具体到LVS的手工配置,通常流程如下:
- 在分发器上启用IP转发功能
- 配置虚拟IP和VIP监听
- 指定后端真实服务器(RS)的IP和端口
- 设置调度算法为状态表更新(以IPVS为例)
- 在后端服务器上配置ARP抑制,避免响应VIP的ARP请求
如果使用Nginx这类七层负载均衡,还要考虑HTTP会话保持,因为浏览器首次请求分流到服务器A,第二次请求却分到了服务器B,若Session数据没共享,用户就得重新登录,解决手段可以是IP_HASH调度或Redis共享Session。
服务器集群的关键支撑技术:不可忽略的底层细节
抛开分类不谈,集群内部有几个底层支撑技术至关重要,这些细节如果没处理好,集群越庞大,带来的故障反而越频繁。
心跳检测机制
所有高可用集群都依赖心跳机制维持节点间“默契”,每台节点会周期性发送握手包给同伴,约定时间窗内没收到回应,就判定对方异常,常用的心跳工具包括Keepalived、Corosync等。
数据一致性协议
当集群中的数据存在多个副本时,需要保证各副本内容同步,这就是数据一致性问题,业内共识是没有绝对的一致性,只有不同等级的一致性保证。 传统的Paxos算法和Raft算法用于实现强一致性;而NoSQL类分布式数据库往往采用最终一致性模型,牺牲短暂的实时性,换取更高的并发性能。
集群会话保持
大部分集群场景都要求“会话保持”,确保同一用户的请求始终到达同一后端节点,在LVS的配置中,使用SH算法(源地址哈希)即可保持同一个用户IP访问落在固定节点上;在Nginx中则可以用sticky模块将Cookie绑定节点。
健康检查机制
负载均衡器还需要实时探测后端节点的存活状态,常见手段有HTTP探测、TCP端口探测、自定义脚本探测,一旦探测失败,该节点会被从调度池中摘除,待恢复后重新加入,这属于可验证的运维自动判定操作,在Keepalived配置中也有专门的real_server健康检测段。
常见服务器集群方案哪个好用:主流软件对比
用户通常会在搜索“服务器集群方案哪个好用”时,带着强烈的场景化需求,其实没有绝对的“最好”,只有“最合适”,这里按当前主流开源方案做横向对比。
| 方案名称 | 所属层级 | 典型用途 | 主动特性 | 主要短板 |
|---|---|---|---|---|
| Keepalived | 四层/高可用 | 提供稳定虚拟IP的故障切换 | 配置相对简单,VIP漂移效率高 | 本身不处理HTTP协议,只解决入口高可用 |
| LVS(Linux Virtual Server) | 四层 | 大流量负载均衡 | 吞吐量在同类方案中常排前列,工作于内核态 | 部署配置门槛高,需做细致网络设置 |
| Nginx | 七层 | HTTP/HTTPS负载均衡 | 支持URL路径、域名等高级路由和缓存 | 七层处理并发能力受限于进程模型 |
| HAProxy | 七层 | 兼顾四层与七层的负载 | 调度规则非常丰富,统计信息完善 | 本身不渲染动态页面 |
| Kubernetes(K8s) | 容器编排层 | 大规模微服务集群管理 | 与服务发现、弹性伸缩、滚动更新深度结合 | 对运维和网络知识要求很高,初期学习曲线较陡峭 |
| 云厂商托管集群方案 | 服务化 | 企业快速上云 | 免运维,可弹性伸缩 | 长期成本可能高于自建,且存在绑定风险 |
按场景选择方案的技术考量
- 公司只有两三台虚拟机,需要做一个可供业务依赖的入口网关:首推Keepalived + Nginx,成本低,维护简单。
- 面向教育科研建模,需要海量并行计算:建议直接采用PBS或Slurm作业调度系统管理的高性能计算集群,节点间通过高速InfiniBand网络互连。
- 公司业务模块复杂,整个技术栈已容器化并微服务化:“服务器集群技术有哪些”的答案大概率是Kubernetes集群,配合Ingress Controller统一接收外部流量,再经由Service层将请求分发至各业务Pod。
相当一部分企业之所以踩坑,是因为不区分业务场景,盲目照搬别人文章中的集群部署教程,结果要么将LVS搭配高复杂度网络模型,把架构搞臃肿;要么在不需要K8s的小规模业务中强行引入容器化集群,造成资源浪费。
中小企业服务器集群怎么搭建:分步选型思路
第一步:评估业务需求和预算边界
搭建前先完成三个明确的任务:
- 定位当前业务并发量区间:是几十人内部办公系统,还是日活上万的外网服务
- 统计可用物理资源:机柜空间、电力能耗、带宽成本都没有确定前,不建议直接采购硬件
- 确定容灾等级:企业核心数据库允许的停机窗口以小时计、分钟计还是秒级
第二步:明确基础架构的组建形式
多数情况下,中小企业适合从“两节点高可用 + 多节点处理”起步,规划示意图通常如下:
- 前端两台Web服务器,通过Keepalived配置为高可用集群并提供VIP
- 两台Web服务器上方由Nginx做七层负载均衡,分发动态请求至多个业务节点
- 后端多台应用服务器节点,配合一台MySQL主从数据库和一台Redis缓存节点
整个集群拓扑的搭建顺序建议先做底层网络配置,再做应用层服务注册。
第三步:按集群类型执行具体部署动作
如果选择高可用集群,可以参照以下操作路径:
- 为所有节点设置固定静态IP,并配置/etc/hosts主机名解析
- 同步各节点系统时间(常用NTP或chrony服务),避免心跳误判
- 配置SSH免密登录,便于集群间各节点交互
- 安装Keepalived,并配置主备节点的
priority值和state参数 - 启动Keepalived服务,并测试主节点宕机时的VIP切换是否在两秒内完成
如果选择负载均衡集群,部署路径变为:
- 在分发器上安装HAProxy或Nginx
- 配置监听端口和后端服务器组
- 开启健康检查参数,设定故障重试次数
- 对分发器自身再做一份高可用配置,防止调度器单点故障
完成部署后,务必进行三组基础验证:停掉一台后端Web服务,观察请求是否自动切换到另一台;关闭主调度器,观察VIP能否正确漂移;使用命令如curl访问VIP,检查返回的HTTP状态码是否符合预期。
第四步:初始化监控告警与日常巡检
任何集群都逃不过故障,关键是要被第一时间发现,建议接入Zabbix或Prometheus监控,对每个节点的CPU使用率、内存使用率、磁盘I/O、网络流量设置阈值告警,每晚定时执行日志巡检,查看内核日志、集群服务状态和磁盘空间是否异常。
集群技术的边界与选型核心路径
服务器集群技术本质上是一个“用空间换时间、用冗余换稳定”的工程实践,它不神秘,但细节确实繁杂,要想用得好,核心路径在于:先明确业务目标是高可用、高性能还是高并发,再选择对应的技术组合。没有万能的集群,只有匹配的架构。 选型时保持克制,能用两台服务器解决的事,别一开始就上容器云。
好文必答:服务器集群常见问题
服务器集群和分布式是一回事吗?
不是。分布式是一种架构思想,指把业务模块拆分到不同机器上协同工作;服务器集群则更强调多台服务器对外提供同一个服务,重在冗余和负载。 简单说,集群里的每一台服务器做的是相同的事情,而分布式系统中的不同节点做的可能是不同的事情,很多高可用架构中既包含集群,也包含分布式拆分,两者是互补关系。
服务器集群是否一定要使用高配置硬件?
完全相反,传统运维的思路是靠“好机器”扛住压力(垂直扩展),而构建服务器集群的初衷恰恰是希望用多台低成本的普通商用服务器(水平扩展)替代昂贵的单一主机,高可用集群中,建议选择相同配置的机器,便于主备切换后性能保持一致,不同配置可能导致备节点接管后服务质量下降。
服务器集群技术是否会淘汰运维岗位?
不会,服务器集群技术给运维提出了更高要求,而不是更低,集群中的节点间关系复杂,误配置则可能产生脑裂、流量风暴、数据分叉等疑难问题,未来企业需要的是理解集群内部原理、能快速定位网络与数据一致性问题的运维工程师,而不是只会敲启动命令的“操作员”。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/806420.html