AI展现优化
-
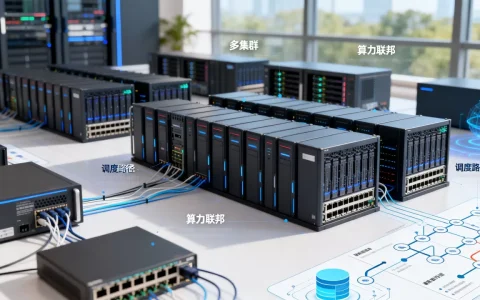
多集群算力联邦调度的可行路径有哪些,怎么实现?
多集群算力联邦调度的可行路径,首先要把“联邦”这件事想明白多集群算力联邦调度没有银弹,但有一条已经被验证的路:通过动态联邦调度层解决全局视图与资源分布问题,再用服务网格打通流量,最后用统一控制面管住配置和策略,这条路径的核心价值在于让多个Kubernetes集群像一个独立的大集群一样被调度,同时保留各集群的自治……
-
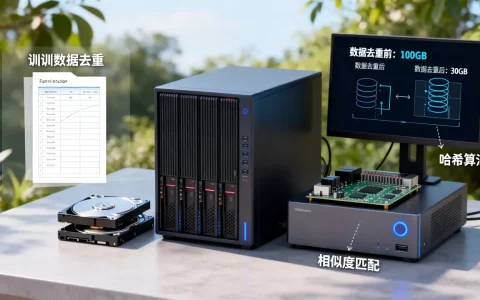
训练数据去重能节省多少存储容量,有哪些方法?
训练数据去重能节省相当一部分存储空间,尤其在图像、视频和日志类数据集上,普遍能省下30%到50%的容量,甚至更高,这并不意味着所有数据都值得去重——文本数据重叠率低,而去重算法的选择与计算开销直接影响实际收益,下文将直接拆解“训练数据去重对存储容量的节省”这件事,讲清楚能省多少、怎么省、用什么工具,以及不同场景……
-
显存占用监控如何落地推理平台,推理平台显存优化技巧有哪些
显存占用监控在推理平台的落地,核心答案是一套“采集-分析-告警-自愈”的四层体系,而非单一工具或命令,这意味着你不仅要看到显存数字,还要理解模型、请求并发与碎片之间的三角关系,否则监控图只是事后诸葛,为什么你的推理平台总在深夜悄悄OOM很多团队把显存监控等同于“看个百分比”,结果GPU卡在深夜悄悄OOM,第二天……
-
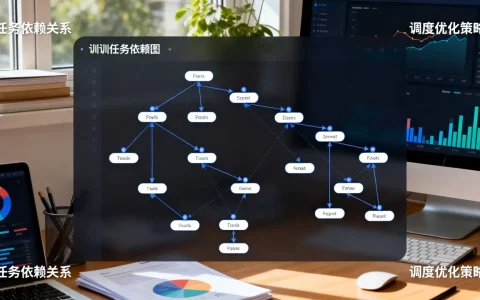
训练任务依赖图如何驱动调度优化,怎么做?
训练任务依赖图驱动的调度优化,核心逻辑是把任务间的先后关系显式建模成有向无环图,让调度器基于全局依赖而非单个任务状态做决策,从而实现资源利用率与训练效率的双重提升,这套思路在近年来的大模型训练和混合负载场景中已被相当一部分团队验证,逐渐取代传统的先来先服务队列调度,下面从依赖图构建、调度策略设计到落地路径,逐一……
-
如何优化大模型长尾请求的处理延迟,有什么解决办法?
长尾请求延迟优化的核心答案大模型长尾请求的延迟优化,核心思路不是堆算力,而是围绕“缓存复用、路由调度、推理模式”这三个层面做系统性瘦身,把冷门请求的无效计算和等待时间压缩到极致, 绝大多数用户碰到的“大模型反应慢”,其实并非模型本身不行,而是请求链路上某个环节卡了脖子,为什么你的模型对热门问题秒回,对冷门问题却……
-
推理痕迹重计算如何节省显存?,显存优化技巧。
推理痕迹重计算不是把已算过的结果扔掉重来,而是主动释放推理过程中”用后即弃”的中间激活值,在需要时用算力换显存,这套思路在长序列推理和超大模型部署场景下,能把峰值显存压缩一个量级,代价仅仅是多花20%左右的GPU时间,目前主流推理框架和国产化适配方案中,这已经是与INT8量化、KV Cache量化并列的三大显存……
-
推理服务协议选择对延迟有何影响,怎么选最优?
推理服务协议选错,延迟差距可能达到数倍,尤其在流式输出和批量请求场景下,HTTP/2 与 gRPC 的组合往往是延迟敏感型应用的更优解,推理服务协议怎么选:延迟差异从哪来很多团队在部署推理服务时,把精力全放在模型精度和显存优化上,等到上线才发现接口响应慢得离谱,协议本身对延迟的影响,往往被严重低估,一个推理请求……
-
训练弹性伸缩中检查点搬迁的成本高不高,如何降低?
训练弹性伸缩中检查点搬迁的成本,本质上是时间成本、存储成本和网络带宽成本的三方博弈,核心矛盾在于IO等待与GPU空转的取舍,近年来,大模型训练集群普遍采用弹性伸缩策略来应对波动的算力需求,当训练任务被抢占或重新调度时,检查点文件需要在节点间迁移,这个过程往往比想象中更耗时,很多用户只关注GPU租赁价格,却忽略了……
-
磁盘吞吐不足为何拖慢数据加载,如何提升磁盘IO性能?
磁盘吞吐不足的本质是存储设备在单位时间内能搬运的数据量跟不上业务请求,这不是单纯换一块更快的硬盘就能解决的,先分清瓶颈出在单盘性能、协议开销还是队列调度,再动手优化,磁盘吞吐不足的典型症状是什么磁盘吞吐不足拖慢数据加载的时候,系统并不是直接蓝屏或者报错,而是像一个人干活时被卡住了手:表面看还在运行,但每一步都慢……
-
显存与主机内存统一寻址如何应用,有哪些应用场景?
显存与主机内存统一寻址,本质上就是让GPU能直接访问系统内存,把显存和内存当一块地儿用,彻底告别手动拷贝数据,这项技术解决了显存容量不够用和数据搬运耗时两大痛点,在AI推理、大数据分析和8K视频剪辑等场景中正快速普及,统一内存和独立显卡区别在哪想搞懂统一寻址,先要明白传统独立显卡的工作方式,以前的GPU干活,得……