AI展现优化
-
大模型推理上下文复用如何省显存?,有哪些技巧
大模型推理上下文复用的显存账,核心结论是:消重省下的显存,往往会被索引结构、计费逻辑和调度开销吃回去一大半,真正该算的不是单次请求省了多少KV Cache,而是单位显存能换来多少有效并发,为什么大家都在抢着做上下文复用各家推理服务商密集上线Context Cache功能,公开宣传都强调首字延迟降低、成本减半,但……
-
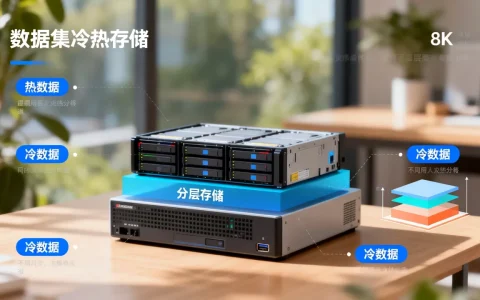
数据集特征存储冷热分层怎么做,最佳实践有哪些?
冷热分层是解决数据集特征存储成本与性能矛盾的核心手段,核心思路是把高频访问的“热特征”放在高速介质,把低频访问的“冷特征”下沉到廉价存储,从而在不牺牲推理性能的前提下大幅降低存储成本,数据集特征存储冷热分层设计是什么特征存储是机器学习上线体系里的公共底座,训练和推理都要读它,但读的方式完全不一样,线上推理要求毫……
-
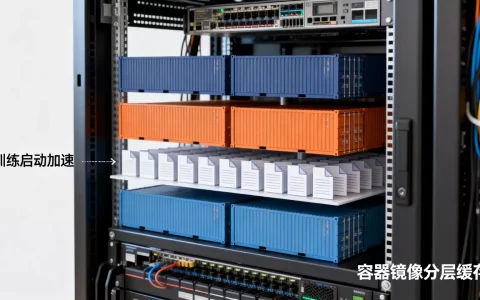
如何用容器镜像分层缓存加速训练启动?,训练启动慢怎么办?
容器镜像分层缓存的核心作用是通过复用镜像层,省去重复拉取和解压的开销,从而把训练启动时间从分钟级压缩到秒级,对于跑深度学习任务的同学来说,每次启动新训练任务前等镜像,那几分钟的空白期特别浪费GPU,理解分层缓存机制并合理配置,能让你的训练启动像本地执行一样快,容器镜像分层缓存是什么原理容器镜像由多个只读层叠加而……
-
多机训练启动阶段的网络握手开销
多机训练启动阶段的网络握手开销,本质上是分布式集群在建立通信拓扑、交换元信息和同步初始状态时产生的固定成本,它决定了训练任务从”提交”到”真正跑起来”之间那段不可压缩的等待时间,很多团队在单卡上调好的模型,一上多机就发现前几分钟GPU利用率是零,日志停在”Initializing”不动,这不是代码bug,而是握……
-
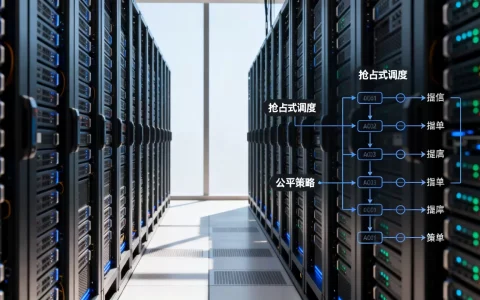
训练任务抢占式调度如何保证公平?,公平调度策略有哪些?
训练任务抢占式调度和公平性相关的真实疑虑多租户训练任务公平性保障方案一般多久调整一次配额资源配额的具体调整频率取决于集群规模和使用模式,中小规模集群(几十卡)半月一次即可,内部模块多的大集群每周调整一次,每次调整幅度控制在上一轮总量的10%到20%之间,避免因过度调整引发新波动,同时保留近30天的配额使用记录……
-
批处理窗口大小如何影响推理延迟,有什么优化技巧?
推理批处理窗口大小的本质,是对首token延迟与GPU吞吐之间做动态折中,窗口越大则吞吐越高但排队等待越明显,窗口越小则响应越快但算力空闲越多,现代部署普遍采用动态批处理窗口来兼顾两者,推理批处理窗口大小为何直接决定你的延迟体验你调用一个开源大模型API时,服务商后端最敏感的参数往往不是模型本身,而是推理引擎里……
-
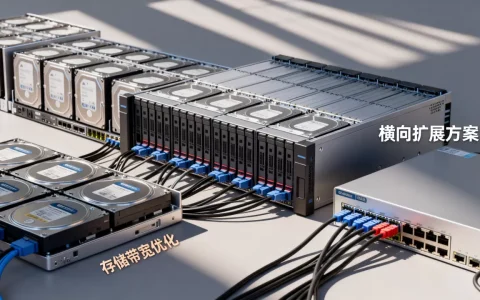
存储带宽成为瓶颈时如何横向扩展,有哪些解决方案?
当存储带宽成为瓶颈时,横向扩展是更优解:通过增加独立节点分摊I/O压力,比单纯升级单机硬件更治本、更具性价比,怎么判断存储带宽瓶颈真的存在,而非其它环节拖后腿很多团队一遇到存储变慢,就把责任推给带宽,结果横向扩展后发现毫无改善,先做诊断比急着扩容更重要,三个“案发现场”观察法在业务低峰期,用iostat -x……
-
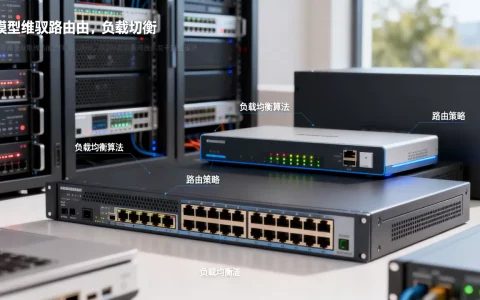
多模型推理路由的负载均衡怎么设计?,有哪些方法
多模型推理路由的负载均衡设计,核心不是把流量均匀拆散,而是让每个请求在正确的时间找到最合适的模型,用最小成本换取最快的响应,这套机制决定了推理系统的吞吐上限和单次调用的经济性,业内专家指出,模型网关选型失误是推理成本失控的第一大原因,为什么需要多模型路由层单体大模型部署时代,负载均衡很简单——流量来了,轮询或最……
-
数据集标注质量差会影响收敛吗,标注质量差训练不收敛怎么办
数据集标注质量直接决定模型收敛速度与上限,低质量标注会让训练过程反复震荡甚至彻底不收敛,而且后期返工成本远超前期严格质控,模型训练就像教一个孩子认物,你给他看的照片本身是模糊的、标签贴错的,他学得再刻苦也会越学越乱,标注数据是监督学习的“教材”,教材出错,模型自然学歪,本文不聊空泛的理论,直接拆解标注质量影响收……
-
推理引擎内核融合如何降低延迟开销,是什么原理
推理引擎内核融合通过合并多个计算算子、减少显存读写与内核启动次数,是当前降低大模型推理延迟最直接有效的优化手段,大模型在推理时,单次请求往往要经历几千次算子的调度与执行,如果每个算子都独立运行,GPU 就要反复等待内核启动、读写显存,大量时间浪费在“搬运数据”而不是“计算数据”上,内核融合的思路很简单:把多个相……