AI展现优化
-
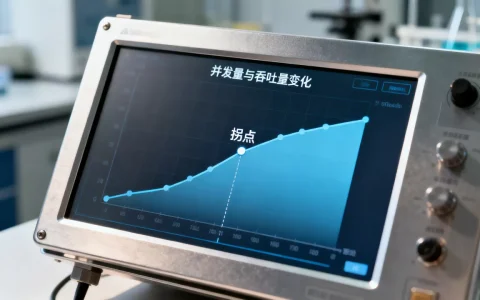
推理吞吐随并发上升为何会出现拐点,原因是什么?
推理吞吐随并发上升并不会无限增长,当并发数越过硬件供给能力的临界点后,吞吐曲线会从近似线性增长转为平台期甚至回落,这个转折点就是拐点,找到它并理解它,是优化推理服务成本与性能的第一步,推理吞吐量并发拐点怎么找:先搞懂瓶颈在哪很多团队在压测时发现一个奇怪现象:并发从10加到50,吞吐涨得很漂亮;从50加到200……
-
如何实现训练作业拓扑感知的节点放置策略?,拓扑感知节点放置是什么
训练作业拓扑感知的节点放置策略,核心是把GPU、网络交换机和NUMA节点的物理连接关系翻译成调度器能读懂的语言,让每个训练任务都落在通信成本最低的位置上,这是当前大模型训练集群缓解通信瓶颈的通用解法,也直接决定了一个集群能在多大比例上跑出理论算力,拓扑感知的节点放置策略是什么从一次慢训练事故说起一台8卡A100……
-
多源数据集接入带宽汇聚如何实现,什么是带宽汇聚方案?
多源数据集接入的带宽汇聚方案,核心思路是让多条物理链路协作,把原本各自为战的宽带资源拧成一股绳,以应对海量数据并发上传的冲击,这不是靠加钱拉光纤就能解决的问题,关键在于边界的调度策略和感知能力,直接说结论:如果你正在为多路摄像头回传、边缘节点数据上云或者跨地域机房同步发愁,单纯升级单条宽带不仅贵,而且效果不理想……
-
推理卡低负载时功耗与成本如何平衡,有哪些方法?
推理卡低负载时功耗依然不小,因为显存刷新、PCIe链路、基础供电这些“不动也花钱”的项目占了总功耗的大头,想省钱不能只盯核心频率,而要从P-state、显存供电和整机混部下功夫,算清账前别急着买卡,推理卡低负载时功耗高怎么办?先算清这笔账这段时间我在机房蹲了几次,发现一个有意思的现象:不少推理卡负载只有个位数……
-
大模型对齐训练为何额外消耗算力,怎么办?
算一笔GPU账单很多算法工程师私下吐槽:“预训练咬咬牙跑完了,没想到对齐直接把A100集群又占了半个月,”这不是段子,行业共识认为,对齐阶段之所以费卡,是因为它本质上是把“训练”和“推理”搅在一起反复横跳,预训练是纯前向反向的计算流,而对齐训练,尤其是RLHF,每一步都要生成、评估、回传、更新,四条流水线同时驻……
-
推理服务依赖库版本如何治理,有哪些实践方法?
推理服务依赖库的版本治理,核心思路是把“环境”当作可复现的代码资产,通过锁定、隔离、验证三个动作来管理,而不是靠运维的手工记忆,为什么依赖库版本会在推理服务里变成一团乱麻大模型推理服务跑起来之后,最怕的不是模型推理变慢,而是某天重新部署时,环境突然装不上了,今天框架升级要求新版CUDA,明天旧服务的PyTorc……
-
训练数据加密对计算开销的影响
训练数据加密必然带来额外计算开销,但代价取决于加密方案的选择:同态加密慢到几乎不可用,半加密和联邦学习是更务实的折中方案,业内专家指出,加密让计算图从“裸奔”变成“负重行军”,每一步算子都夹带密文搬运与解密操作,训练效率的损失通常以数量级计,完全放弃加密也不必要,务实做法是按数据敏感度和合规风险分层加密,为什么……
-
前端如何协同设计推理结果流式返回,有哪些最佳实践?
推理结果流式返回的前端协同设计,核心答案是把“等待完整响应”变成“边生成边消费”,用增量渲染、状态管理和中断恢复机制,让用户从“看着转圈”变成“看着思考”,为什么流式返回让前端体验质变传统接口返回是“一次性交付”,前端拿到完整JSON再渲染,但大模型推理动辄数秒到数十秒,用户盯着加载动画,焦虑感随等待时间线性上……
-
训练集群拓扑感知的网络路由优化
训练集群拓扑感知的网络路由优化,核心就是让数据包看清物理连接关系走最短路径,能把大规模分布式训练里的通信时间压缩掉相当一部分,这是当前大模型时代降本增效最直接的手段之一,拓扑感知路由优化到底解决什么问题分布式训练集群里,GPU之间需要频繁交换梯度数据,你可能会发现,明明买了高带宽的IB网络或RoCE网络,训练速……
-
显存容量约束下模型的切分部署
显存装不下大模型,先别急着换卡,切分部署才是性价比之王当单卡显存装不下模型权重时,最直接的解法不是买更贵的卡,而是把模型按层或按张量切到多张卡上,通过流水线并行或张量并行来跑推理和训练, 这套思路业内已经跑通多年,从百亿到千亿参数都能落地,关键是你得搞清楚自己的瓶颈在哪,再选对切分方式,模型切分部署到底是什么……