AI展现优化
-
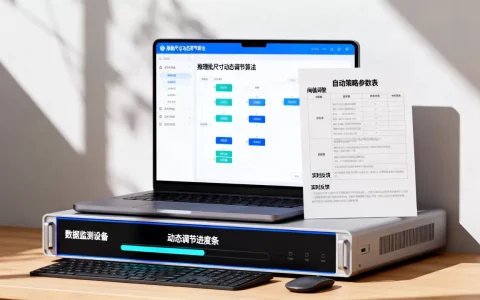
推理批尺寸动态调节怎么实现,有哪些自动策略?
推理批尺寸动态调节的核心答案不是“调一个固定值”,而是让引擎在每次迭代中根据显存水位、请求队列长度和请求类型自动决定batch size,优先保证吞吐稳定而不被某一个大请求堵死,大模型上线之后,很多人还抱着玩传统深度学习的习惯,把batch size当成一个超参,调完就固定不动,但推理场景的输入长度是动态的,请……
-
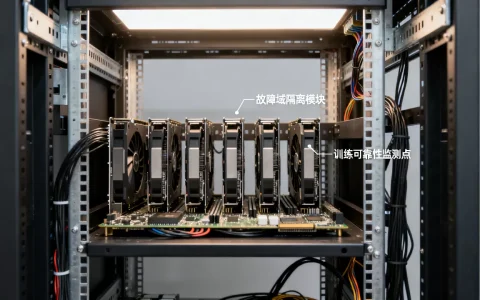
多卡故障域隔离能提升训练可靠性吗,为什么?
GPU服务器多卡训练故障隔离方案:炸卡前划好边界多卡训练被迫中断,绝大多数情况不是算力不够,而是单卡故障没有在本地被关住,让整组训练陪葬,用故障域隔离把一张卡的故障限制在它自己身上,训练就不至于从头再来,大模型训练任务动辄几百卡协同,单卡显存报错、掉卡、通信超时这类硬故障,几乎每个大规模训练团队都会遇到,没有故……
-
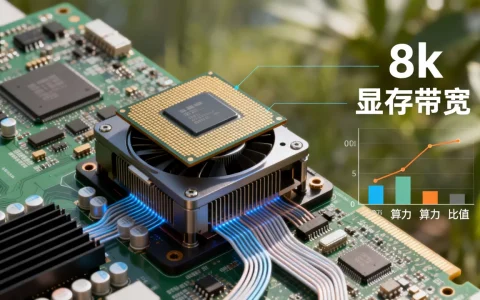
显存带宽与算力比值如何影响计算效率,为什么带宽要与算力匹配?
显存带宽与算力比值,决定你GPU实际效率的隐藏标尺显存带宽与算力比值(Bytes/FLOPs)是衡量GPU能否充分“喂饱”计算核心的关键指标,比值过低则算力闲置,过高则显存浪费,多数深度学习场景下,这个比值在0.35到0.8之间运行时能效最佳,很多人买显卡只看显存大小和FP16算力,结果跑大模型时发现利用率上不……
-
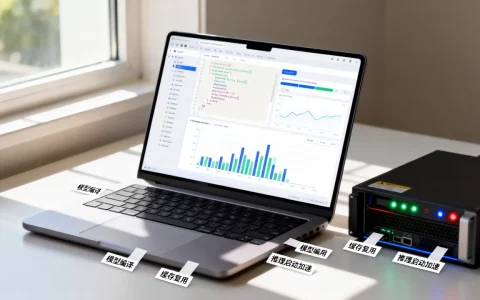
模型编译缓存复用如何加速推理启动,有哪些优化方案?
模型编译缓存复用是当下加速推理启动最直接、成本最低的手段,通过复用编译产物,推理框架能跳过耗时最长的算子编译阶段,多数场景下可将冷启动时间缩短一个数量级以上,这个结论来自一个让不少人踩过坑的日常:模型训练好之后,部署到推理环境,第一次调用总是卡顿明显——很多情况下,启动几秒、几十秒甚至更久,都耗在了同一条路上……
-
如何消减超大模型流水并行的气泡?有哪些技巧
流水并行的气泡本质是“等”,等前一个stage算完,等后一个stage把梯度传回来,这期间GPU空转就是气泡,消减气泡的核心思路只有三条:把任务拆得更碎、把顺序排得更好、把空闲时间用来做别的,流水并行气泡到底是怎么冒出来的很多人在本地调通单卡训练后,第一次上多卡流水并行,发现GPU利用率惨不忍睹,打开nsys或……
-
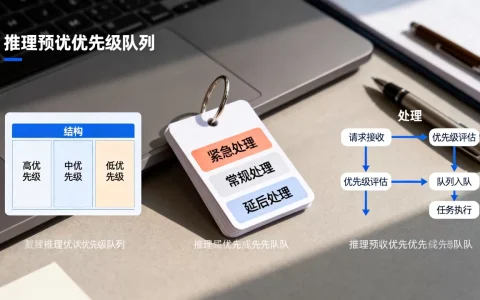
推理请求优先级队列如何设计?有哪些要点?
推理请求优先级队列的核心价值,在于用确定的调度策略,换回不确定的算力消耗——它能直接决定你的服务是“首屏秒开”还是“排队转圈”,设计这套队列不是堆功能,而是在延迟目标、吞吐上限、成本预算之间找到那一组平衡参数,高并发场景下如何设计推理请求优先级队列当请求量瞬间翻倍时,最容易暴露设计缺陷,以一个具体的在线图片生成……
-
混合部署下在线与离线任务争用的原因是什么?,如何解决
混合部署下在线与离线任务的争用,本质是CPU、内存、磁盘IO和网络带宽的分配博弈,核心解法是分层隔离加优先级抢占,单纯靠调参救不了生产环境,在线任务和离线任务为什么非要挤在一起云服务器成本年年涨,尤其是GPU机器和高端CPU机型,不少公司把目光投向混合部署,说白了就是让在线任务和离线任务共享同一批物理机,在线任……
-
训练状态持久化对存储IOPS吞吐要求多高,如何优化存储性能?
训练状态持久化的IOPS需求不是一个固定值,它由模型参数量、保存频率、并行策略和落盘协议共同决定——单卡训练多为千级IOPS,而大规模GPU集群并发保存时,存储系统需要支撑数十万IOPS和每秒数十GB吞吐,才能把checkpoint落盘时间压进秒级,选型一旦失误,一次原本几秒的保存操作会被拉长到几分钟,训练卡在……
-
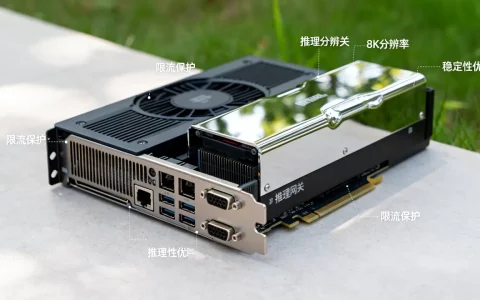
推理网关如何限流保护后端显卡,稳定性优化方法有哪些?
推理网关的限流策略直接决定了显卡是稳定输出还是频繁掉线,核心结论是:在请求到达显卡之前,用队列和并发控制把流量“削峰填谷”,才能让GPU始终工作在安全水位线上,显卡为什么总在深夜宕机后端显卡被压垮,多数时候不是算力不够,而是流量到达的方式太粗暴,想象一下,上千个推理请求同时打到一张A100上,显存瞬间被占满,计……
-
大模型词表扩展对显存的影响大吗?,怎么办?
大模型词表扩展会增加显存占用,增量主要体现在Embedding层,且推理阶段KV Cache的隐性涨幅往往被低估,词表扩展的显存增量从哪来Embedding矩阵:最直接的显存黑洞大模型的词表扩展第一步就是改Embedding层,假设原始词表规模为V,隐藏层维度为H,Embedding参数量就是V乘以H,以LLa……