服务器测评
-
H5如何打开服务器文件?h5调用本地文件路径
在H5页面中直接打开服务器文件,核心在于通过后端接口将文件流(Stream)或临时URL返回给前端,而非直接暴露文件路径,具体方案取决于文件类型是文档、图片还是视频,很多开发者在搭建移动端H5应用时,常遇到一个痛点:用户点击列表中的“查看文件”,页面却白屏或下载了文件而不是直接预览,这通常是因为前端试图用<……
-
Hadoop大数据笔记怎么学?Hadoop大数据学习路线
Hadoop大数据笔记的核心在于掌握HDFS分布式存储与MapReduce计算引擎的协同机制,通过合理配置资源调度与数据分片策略,解决海量非结构化数据的高效处理与存储难题,在数字化转型的深水区,企业面对的数据量早已突破PB级,传统的单机数据库架构在面对这种规模的数据时,往往显得力不从心,Hadoop生态系统的出……
-
Hadoop是数据库吗,Hadoop和数据库的区别
Hadoop并非传统意义上的关系型数据库,而是一个用于海量数据分布式存储与批处理计算的开源框架,其核心定位是数据基础设施而非直接面向业务查询的数据库系统,Hadoop的本质:是存储计算平台而非数据库很多初学者容易混淆Hadoop和MySQL、Oracle等数据库的概念,这种混淆主要源于它们都涉及“数据”二字,但……
-
H5网站建设有哪些核心技巧?H5网站制作费用及周期
H5网站建设并非简单的页面拼接,而是基于移动端交互逻辑、加载速度与转化目标的系统化工程,其核心价值在于以最低的开发成本实现跨平台的高效触达,H5网站与原生APP及传统PC站的深度对比在决定采用何种技术形态前,厘清不同载体的优劣是决策的关键,H5网站并非要完全取代原生APP,也不是PC站的简单缩小版,它在特定场景……
-
Hive数据仓库操作有哪些技巧?hive数据仓库搭建教程
Hive数据仓库的核心操作是通过HQL语句完成数据的加载、转换与查询,关键在于理解其底层基于MapReduce或Tez的执行机制,并合理优化分区与分桶以提升查询效率,在大数据生态系统中,Hive扮演着连接关系型数据库思维与分布式存储系统的桥梁角色,对于很多刚接触大数据的技术人员来说,面对海量的日志数据或业务报表……
-
H3C防火墙如何配置NAT双向地址转换?
H3C防火墙实现NAT双向地址转换的核心在于正确配置内网到外网的源地址转换(SNAT)以及外网到内网服务器的目的地址转换(DNAT),通过NAT策略与地址池的精准绑定,即可打通内外网通信链路,在企业网络架构中,防火墙不仅是安全边界,更是流量转换的中枢,很多网络工程师在初次接触H3C设备时,往往对单向NAT驾轻就……
-
Hadoop大数据类型有哪些?Hadoop常用数据类型详解
Hadoop大数据类型并非单一技术,而是涵盖HDFS、MapReduce、Hive、Spark及HBase等组件的生态系统,其核心价值在于通过分布式架构解决PB级海量数据的存储与计算难题,在数字化转型的深水区,企业面对的数据不再仅仅是简单的表格,而是包含日志、视频、传感器读数等异构信息的洪流,传统的单机数据库早……
-
H2数据库服务器模式怎么用?H2数据库服务器模式配置方法
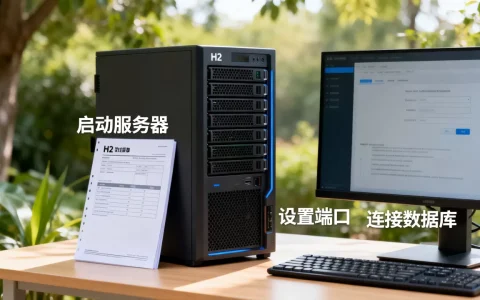
H2数据库服务器模式的核心优势在于无需独立安装数据库软件,通过Java代码即可启动嵌入式服务,实现轻量级、零配置的数据持久化,特别适合嵌入式系统、单元测试及小型Web应用,H2数据库服务器模式的核心机制与适用场景很多开发者在接触H2数据库时,往往只将其视为一个内存中的测试工具,H2提供了两种主要运行模式:嵌入式……
-
Hive行式存储是什么?Hive行式存储和列式存储的区别
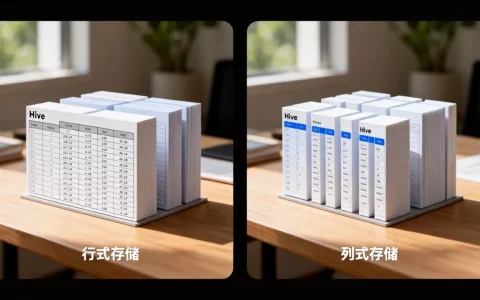
Hive行式存储主要适用于需要频繁检索单行完整数据的场景,如用户画像查询或日志详情查看,但在大规模数据聚合分析中,列式存储才是性能更优的选择,在大数据生态系统的演进过程中,存储格式的选择直接决定了查询效率与资源消耗,很多初学者容易混淆Hive中不同存储格式的应用边界,往往在需要全表扫描聚合时误用了行式存储,导致……
-
h2数据库源代码到底怎么分析?h2数据库源码解读
H2数据库源代码分析的核心在于理解其基于Java的纯内存与磁盘混合架构,通过解析其核心类如PageStore和Transaction, 开发者能精准掌握其轻量级事务处理机制与零配置特性,从而在嵌入式场景或微服务单元测试中实现高效的数据持久化,深入剖析H2数据库的源代码,并非为了复现一个关系型数据库引擎,而是为了……