大模型LoRA微调的秩(Rank)选择没有绝对标准,核心原则是在显存预算、训练速度与模型性能之间寻找平衡点:通常建议从Rank=8或16起步,若发现模型“学不会”或效果停滞,再逐步提升至32或64,切忌盲目追求高秩。
在微调大语言模型时,Rank(秩)决定了低秩适配矩阵的维度,它直接控制了可训练参数的数量和模型的表达能力,选得太低,模型像被捆住手脚,学不到复杂逻辑;选得太高,不仅显存爆炸,还容易过拟合,变成只会死记硬背的“书呆子”,业内专家指出,Rank的选择本质上是一个资源与能力的权衡过程,理解其背后的逻辑比记住几个固定数值更重要。
理解Rank与Alpha:微调的核心杠杆
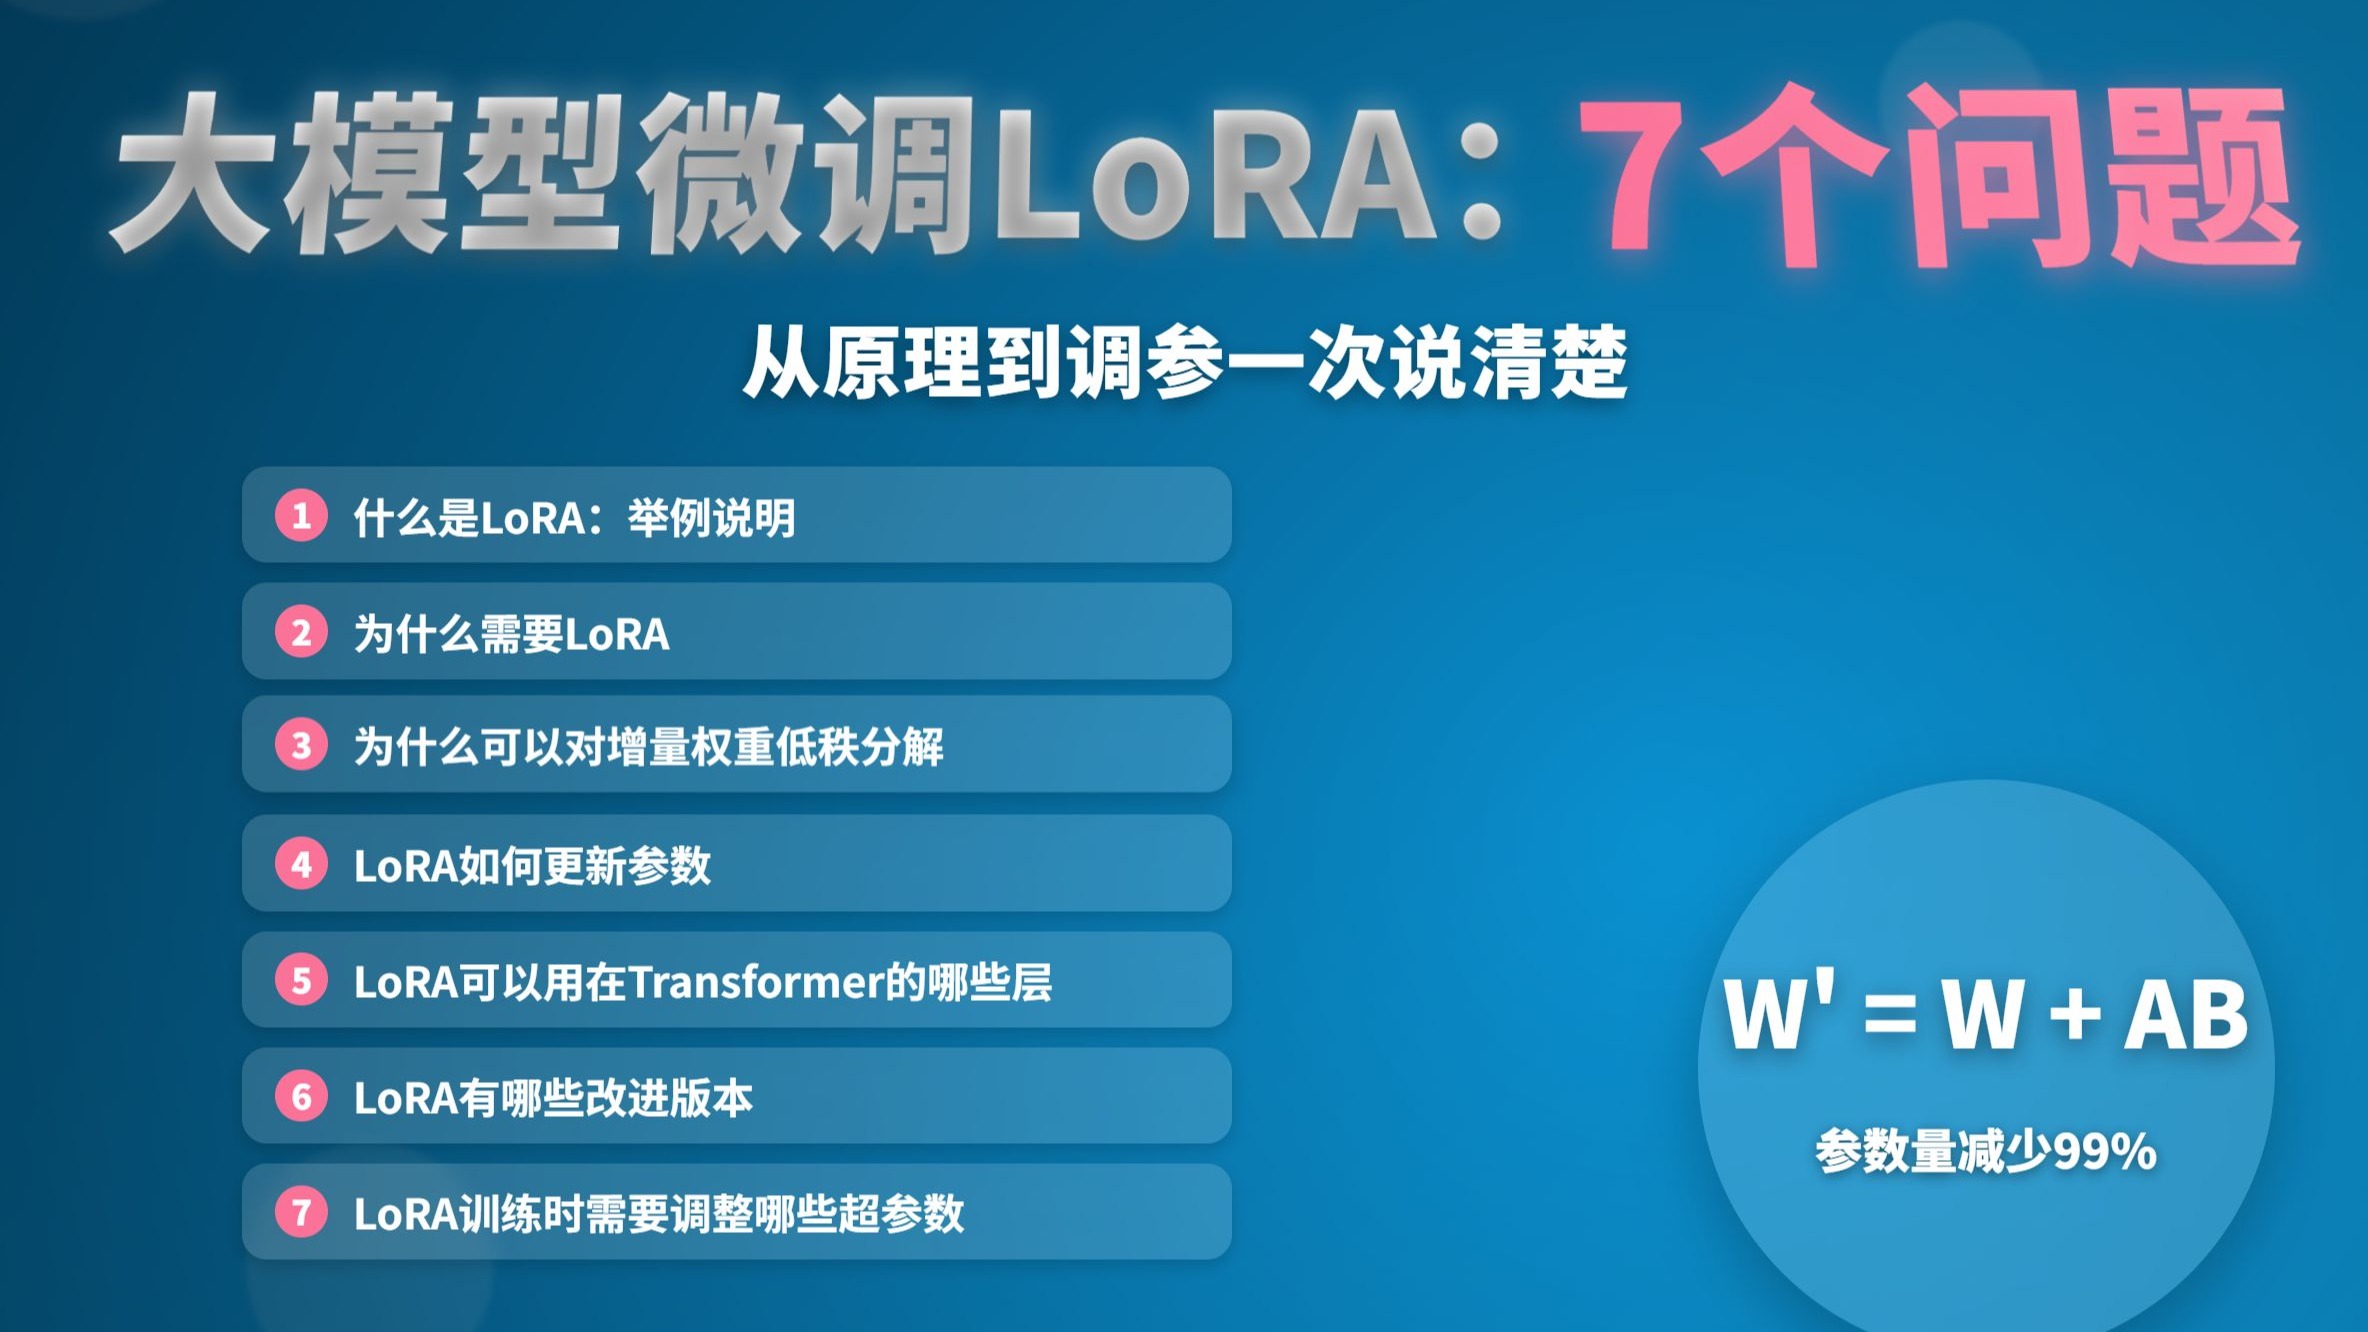
要选对Rank,首先得搞懂它在LoRA机制里扮演什么角色,LoRA通过冻结预训练模型的权重,只训练两个低秩矩阵A和B来模拟权重的变化,Rank就是这两个矩阵的中间维度,它决定了信息流动的“管道粗细”。
Rank如何影响模型容量
你可以把Rank想象成水管的直径,直径越大,能流过的水(梯度信息)就越多,模型能捕捉的特征也就越丰富,水管粗了,需要的材料(显存)和铺设时间(训练时间)也会成倍增加。
- 低秩(Rank 4-16):适合简单任务,如风格迁移、特定格式输出,参数少,训练极快,但可能无法处理复杂的推理逻辑。
- 中秩(Rank 32-64):通用性最强,适合大多数指令微调场景,能在性能和资源之间取得较好的平衡,是大多数开发者的首选区间。
- 高秩(Rank 128+):适合极度复杂的领域知识注入或代码生成,参数量巨大,极易过拟合,且训练成本高昂,通常仅在资源充足且任务极难时考虑。
Alpha与Rank的比例关系
Alpha是缩放因子,通常设置为Rank的倍数(如Alpha=2Rank或Alpha=Rank),这个比例决定了LoRA层对原模型权重的影响力度,如果Alpha设置过大,微调过程可能会破坏预训练模型原有的通用能力;如果过小,则微调效果不明显,行业共识认为,保持Alpha与Rank的固定比例(如1:1或2:1)是稳定训练的基础。
实战场景下的Rank选择策略
不同的应用场景对模型能力的要求差异巨大,盲目套用同一套参数是新手最常见的错误,我们需要根据具体的业务需求来定制Rank值。
简单指令跟随与风格模仿
如果你只是想让模型学会用“鲁迅的语气”写日记,或者将JSON格式转换为Markdown表格,这类任务对逻辑深度的要求极低,过高的Rank只会带来无谓的计算浪费。
- 推荐Rank:4-8
- 操作建议:使用较小的学习率,因为低秩空间已经足够表达简单的映射关系。
- 验证方法:观察验证集Loss是否快速下降,如果Loss在几个epoch内就收敛,说明Rank已足够,无需增加。
垂直领域知识注入
当任务涉及法律条文解读、医疗诊断建议或特定行业的代码生成时,模型需要记忆大量专业术语和逻辑链条,这时候,低秩空间可能无法容纳如此密集的知识分布。
- 推荐Rank:32-64
- 操作建议:增加训练数据量,并适当调高Alpha值以增强特定领域的权重更新。
- 注意事项:需警惕过拟合,如果训练集表现完美但测试集崩盘,说明Rank过高或数据单一,应尝试降低Rank或增加数据多样性。
代码生成的特殊考量
代码生成任务对逻辑严密性要求极高,研究表明,代码任务的LoRA微调通常需要比自然语言处理更高的Rank才能捕捉到细微的语法结构变化,建议从Rank=32起步,若发现模型频繁出现逻辑错误,再逐步提升至64。
显存限制与硬件适配指南
Rank的选择往往不是由性能决定的,而是由你的显卡“兜底”能力决定的,在显存有限的情况下,必须做出妥协。
显存占用估算
LoRA的显存占用主要取决于Rank的大小和模型的参数量,对于7B参数的大模型,每个Rank大约占用几百MB到1GB的显存(取决于优化器和精度)。
| 模型规模 | 推荐Rank | 预估额外显存占用 (FP16) | 适用硬件参考 |
|---|---|---|---|
| 7B | 8-16 | 1-2 GB | RTX 3090/4090 (24GB) |
| 13B | 16-32 | 3-5 GB | A100 40GB / 双卡3090 |
| 70B | 16-32 | 10-20 GB | 多卡A100 80GB / H100 |
注:以上数据为经验估算,实际占用受Batch Size、梯度累积步数及优化器类型影响。
显存不足时的替代方案
如果你的显卡跑不动高Rank,不要急着换硬件,可以尝试以下优化手段:
- 使用Q-LoRA:将基座模型量化为4-bit或8-bit,可以大幅释放显存,允许你在相同硬件下使用更高的Rank。
- 梯度检查点(Gradient Checkpointing):通过以时间换空间,减少激活值的存储,从而允许更大的Batch Size或Rank。
- 混合精度训练:确保使用BF16或FP16格式,避免使用FP32导致显存瞬间溢出。
Rank选择常见误区与避坑指南
在实际操作中,许多开发者容易陷入一些思维陷阱,导致微调效果不佳。
Rank越高越好
这是一个典型的线性思维误区,高Rank并不意味着更好的泛化能力,反而极易导致过拟合,模型可能会记住训练集中的噪声,而在未见数据上表现糟糕,多数情况下,Rank=32已经能覆盖90%以上的应用场景,除非你有特殊的复杂逻辑需求,否则不要盲目追求128或更高。
忽视Alpha的影响
有些用户只调Rank,却用默认的Alpha=1,这可能导致微调力度不足,建议将Alpha设置为Rank的1倍或2倍,并在训练初期观察Loss曲线,如果Loss下降缓慢,可适当增大Alpha;如果Loss震荡剧烈,则需减小Alpha或降低学习率。
一次性训练到底
不要试图用一个固定的Rank解决所有问题,最佳实践是“迭代式微调”:先用低Rank(如8)快速验证数据质量和流程,确认无误后,再切换到高Rank(如32或64)进行正式训练,这种策略既能节省算力,又能确保最终模型的表达能力。
FAQ:关于LoRA Rank的常见疑问
LoRA微调的Rank怎么选才能兼顾速度与效果?
建议采用“小步快跑”的策略,首先使用Rank=8或16进行小规模测试,验证数据清洗和训练脚本的正确性,如果测试集效果满意,直接使用该Rank进行全量训练以追求速度;如果效果未达标,再逐步将Rank提升至32或64,这种阶梯式提升能避免在低效参数上浪费大量时间。
Rank和Alpha的比例一般设为多少合适?
业界常用的比例是Alpha = Rank 或 Alpha = 2 Rank,如果Rank设为32,Alpha可以设为32或64,这个比例决定了LoRA更新量对原模型权重的缩放系数,比例过大容易导致训练不稳定,比例过小则微调效果微弱,建议从Alpha=Rank开始尝试,根据验证集表现微调。
显存不够时,降低Rank还是降低Batch Size?
优先降低Batch Size,因为Batch Size直接影响显存占用的线性增长,而Rank的影响相对较小且非线性,如果降低Batch Size后显存仍有富余,但训练速度慢,此时再考虑适当提高Rank以增强模型容量,如果显存极度紧张,应优先考虑使用Q-LoRA技术,而非单纯降低Rank,因为Q-LoRA能在保持较高Rank的同时释放大量显存。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/394838.html