北京GPU服务器租用怎么对比服务商能力,核心不是比谁的参数漂亮,而是看硬件的实际算力释放、网络质量、存储读写速度和故障响应效率,跑分再高,一跑深度学习任务就降频掉速,等于白租。
北京GPU服务器租用怎么对比服务商能力,别只看参数表
不少团队选服务商时,习惯把芯片型号、显存大小和CPU代次摆在第一位,这个思路没错,但只对了一半,同型号的A800或H800,在不同的机房环境里,实际表现能差出近两成,差距不是芯片本身造成的,而是供电、散热、PCIe拓扑和固件设置这些细节。
芯片型号和显存只是起点
配置表写的是“英伟达某型号GPU”,但你怎么知道它是不是满血版?部分服务商把降频版芯片跟标准版混着卖,还遇到过把同型号不同代际产品混搭的案例。
- 向服务商索要芯片的SM数量和显存带宽,这两个参数直接决定计算吞吐。
- 留意供电方案,单卡功耗高的型号,供电跟不上就会自动降频。
- 散热决定长时间任务是否能稳定在高频率,水冷和强风冷比普通风冷在连续训练中有明显优势。
跑分对照:同配置,不同算力
行业共识认为,同配置GPU服务器的算力差异,多数情况下源于机房散热和供电设计,选服务商前,要求提供同一型号机器在不同负荷下的实测数据,而不是只看理论峰值。
实操验证方式:
- 用
nvidia-smi查看当前显卡的功耗上限和温度阈值。 - 跑
gpu-burn持续压测20分钟左右,观察核心频率是否会掉。 - 相比跑分软件,更建议直接拿你自己的训练模型试跑一个epoch,看时间是否符合预期。
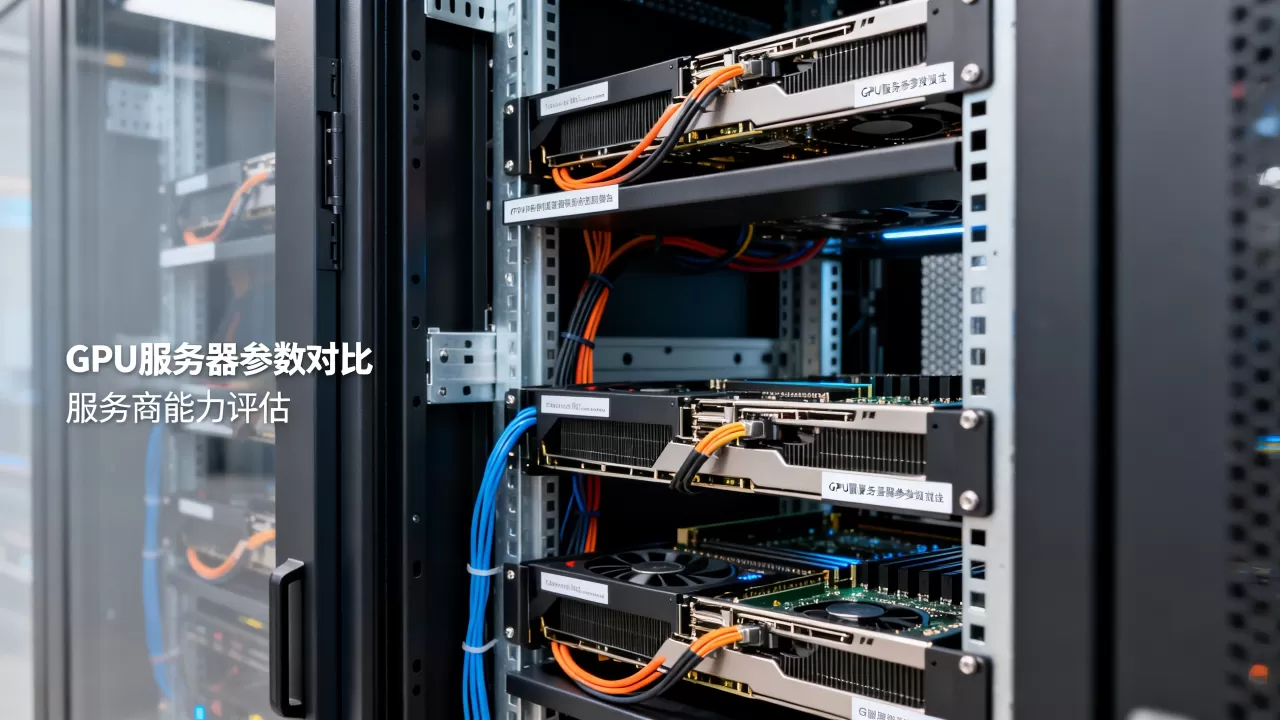
显存带宽、NVLink、PCIe拓扑,一眼看出猫腻
单卡推理任务对显存带宽不敏感,但多卡训练任务完全不一样,分布式训练需要频繁交换梯度数据,NVLink连接和PCIe通道数会直接暴露服务商的真功夫。
对比时需要确认:
- 多卡互联方式是NVLink还是PCIe,NVLink的空闲带宽远高于PCIe通道。
- GPU卡插在哪些PCIe插槽上,x16和x8的差距在训练场景下很可感知。
- 内存通道是否填满,不少廉价配置只插了一半内存条,导致CPU与GPU之间的搬运效率腰斩。
分布式训练场景下GPU服务器怎么选,网络和存储才是分水岭
如果只跑单机单卡,网络配置差点无所谓,但做LLM微调或大规模深度学习训练时,内网带宽和外网质量直接影响你能跑多大的模型,以及跑完一个epoch需要多久。
内网延迟和带宽决定多机训练效率
多机训练依赖参数服务器或AllReduce架构,每一次迭代都要同步梯度,IB网络(InfiniBand)和RoCE网络在时延、吞吐上碾压普通万兆以太网,如果服务商给的是千兆内网,两台机器之间同步一次梯度就要卡好几秒,训练基本没法做。
- 确认机房内部网络架构是Spine-Leaf还是传统三层,前者带宽收敛比低,跨机通信更稳。
- 要求测速:在租用的机器上用
iperf3测试两台GPU服务器之间的TCP和RDMA带宽,数值不应大幅低于标称值。 - 看公网入口是BGP多线还是单线,若你的数据源或输出端在多个运营商网络,单线链路容易出现跨网延迟和丢包。
存储挂载方式决定数据加载速度
数据加载是大规模训练中最容易被忽略的瓶颈,GPU的计算速度再快,数据管道堵塞了,显卡也只能空转,服务商能提供的存储方案,通常分为本地SSD、分布式文件存储和对象存储三种。
不同方案的适用场景:
- 本地NVMe SSD:读取速度最快,适合高性能计算,但容量有限,数据冗余靠你自己备份。
- 分布式文件存储(例如GlusterFS或Lustre方案):适合多机共享数据集,省去反复拷贝。
- 对象存储(S3兼容):适合冷数据存放,直接挂载到训练任务会严重影响随机读取速度。
对比时重点关注IOPS和单文件读取带宽,有服务商宣传存储“高性能”,但实际用的是机械盘阵列,几百个G的训练集加载一次要等半小时,相当常见。
北京GPU服务器租用价格怎么对比才不算白花钱
价格是大部分用户最关心的部分,但只比每小时单价,容易在后付费阶段被各种附加成本搞到预算超标,北京GPU服务器租用价格怎么对比,重点看账单组成的透明度,以及是否存在隐性扣费。
价格构成拆解:不是只有“每小时几块钱”
一份正常的GPU租用账单,应该包含算力资源费、硬盘容量费、公网带宽费、IP地址费,有些服务商还会另收镜像存储费和快照费。
对比价格时,先把所有费用列出来再算总账。
- 算力单价低,但公网带宽按流量每GB收费很高,数据传输量大的场景会吃暗亏。
- 存储费按使用量而非套餐容量计算,超出部分价格可能翻倍。
- 续费保护策略是否齐全,部分服务商在欠费后直接释放实例,数据无法找回,造成额外损失。
业内专家指出,低价机器的成本缺口往往出现在三个地方:旧款硬件冒充新款、带宽拥挤导致高峰时段掉速、故障后恢复时间长但不在赔付范围。
低价机器为什么便宜,钱省在哪
北京GPU服务器租用遇到过一类典型情况:同样标称的配置,A服务商比B便宜四成,租来一测,性能差出一截,原因是供电限幅设置过低,GPU满载运行不超过5分钟就开始降频。
省下的钱还来自于服务性质的缩水:
- 不提供7×24小时的人工客服,故障响应靠工单,效率很低。
- 不包含免费的数据备份服务,硬盘损坏时你的训练数据只能自认倒霉。
- 没有SLA(服务等级协议)承诺,宕机时间不补偿。
包年包月和按量付费怎么选
如果你的任务是持续数周的模型训练,包年包月更划算,临时跑个测试或做短周期推理验证,按量付费更灵活,多数服务商会给出这两套计费模式,关键是搞清楚变更规则。
- 按量付费转包年包月是否免手续费。
- 包年包月是否支持中途降配,剩余金额怎么结算。
- 实例释放后,系统盘和数据盘数据保留几天。
- 是否提供竞价实例或闲置实例池,适合可中断的离线任务。
实操:三步验收法,把同配置机器拉出来遛遛
价格和参数说再多,不如开机实测,以下三步不需要特殊技能,用常见Linux命令就能完成,三步走完,你对这家服务商的底子会有清晰认知。
第一步:GPU压测,看瓶颈在哪
- 安装
gpu-burn,运行20分钟,通过nvidia-smi持续观察功耗是否稳定在标称值附近。 - 记录最高温度和风扇转速,对照芯片规格判断散热是否正常。
- 使用
nvidia-smi dmon监测GPU利用率波动,过大的锯齿状波动表示供电不稳定。
第二步:网卡和存储实测
- 用
iperf3两端互跑,对比TCP带宽是否接近网卡标称值。 - 检查网卡型号和链路速率,确认是25GbE、100GbE还是万兆。
- 用
dd或fio测试磁盘顺序读写和随机读写,用一个4GB文件分别做顺序读、随机读测试,记录耗时差异。 - 测试跨可用区的VPC内网延迟,用
ping看RTT波动范围,稳定延迟比极低延迟更重要。
第三步:服务商调试响应测试
真正需要的服务能力,出现故障时才能看出来,通过工单或在线客服提一个非紧急的配置变更需求,看对方多久响应、多久完成操作,响应快和操作熟练度,往往反映运维团队的专业程度。
同时明确故障赔偿标准:实例宕机多久开始计算补偿,是折算成使用时长还是现金返还,这些条款都写进合同才有保障。
Q&A:北京GPU服务器租用对比服务商能力,最常问的两个问题
问:北京GPU服务器租用哪家好,是不是直接选价格最低的就行?
不是,价格最低的机器,常用减配手法包括:降频芯片、缩水散热、共享带宽、机械硬盘存储,租用前先试用,跑通你的典型业务场景再决策,按需选择比迷信品牌更可靠,小服务商在某些硬件规格上反而更透明。
问:怎么判断一家服务商的真实能力?
实际测试是最靠谱的方式,看它能否提供临时测试机,愿意提供短时免费测试或按小时计费的,通常对自身产品有底气,测试时覆盖GPU稳定性、网络延迟、存储速率和服务响应四块内容,全部达标再签长期合同,最终决策依据不是宣传文案,而是你亲手测出来的数据。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/751021.html