查服务器CPU和内存使用率,Linux优先用 top、htop、free -h,Windows用任务管理器或 Get-Counter;线上云服务器还要叠加云监控和Prometheus看历史趋势。
下面按Linux、Windows、云服务器排查、工具选型和常见问题讲清楚,命令可以直接复制使用。
Linux服务器怎么查看CPU和内存使用率
命令行快速看整体:top与free -h
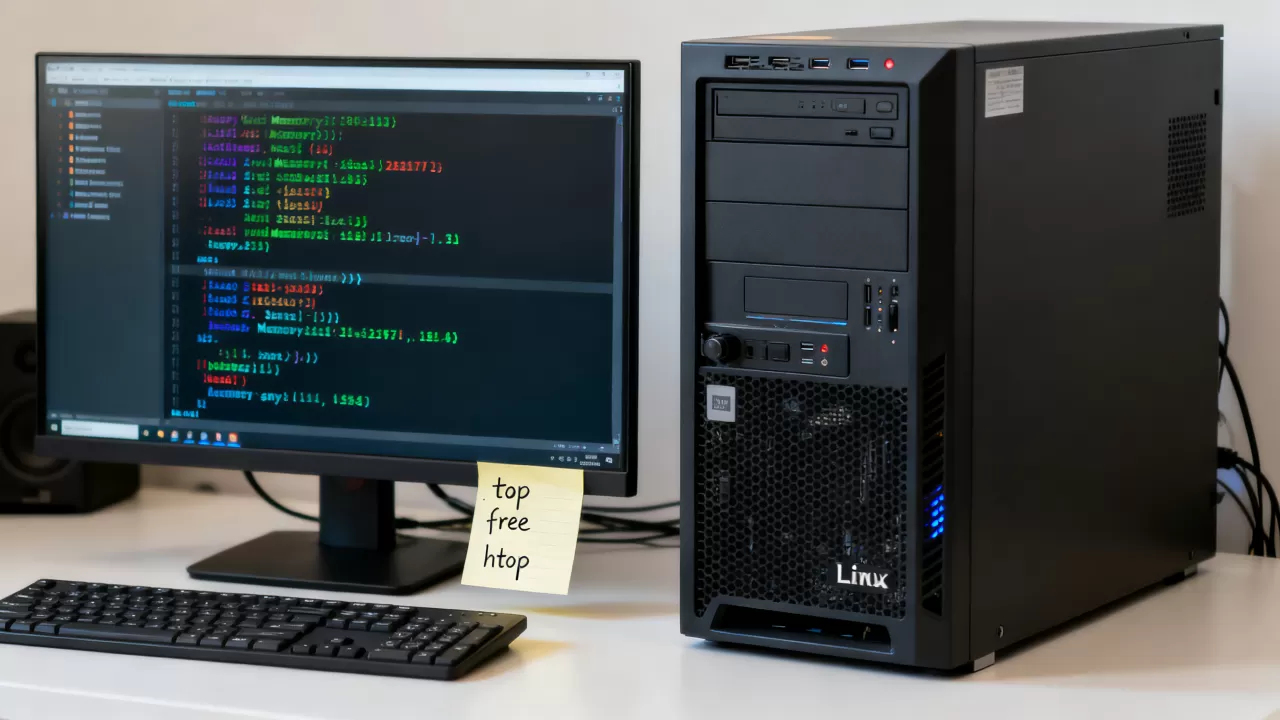
登录SSH后,先敲 top,它像服务器的仪表盘,第一行看 load average,第三行看CPU状态。us是用户态,sy是内核态,id是空闲,wa是IO等待,按 1 展开每个核心,按 P 按CPU排序,按 M 按内存排序,按 q 退出。

内存不要只看 free,要看 available,执行:
free -hcat /proc/meminfouptime
buff/cache占用的内存通常可回收,available才是应用还能用的内存。swap被大量使用,说明物理内存已经紧张。 available持续偏低、swap频繁读写,才是加内存或优化程序的信号。
定位具体进程:ps、pidstat、htop
整体指标高,下一步就是找“谁在吃资源”。
ps aux --sort=-%cpu | head -10找CPU占用最高的进程。ps aux --sort=-%mem | head -10找内存占用最高的进程。pidstat -u -p PID 1持续看某个进程的CPU。pidstat -r -p PID 1持续看某个进程的内存。htop更直观,F6排序,F9结束进程,安装命令:yum install htop或apt install htop。
如果某个Java或Python进程CPU长期接近单核上限,先看线程栈和日志,再决定扩容还是改代码。
看历史趋势:sar、vmstat、mpstat
临时排查用 top,历史回溯用 sar。
vmstat 1看r、b、si、so、wa。mpstat -P ALL 1看每个CPU核心。sar -u 1 5看CPU历史。sar -r 1 5
看内存历史。
iostat -x 1看磁盘IO,辅助判断wa高不高。
这些命令依赖 sysstat,很多系统默认没开历史采集,需要修改 /etc/sysconfig/sysstat 或 /etc/default/sysstat,再启动服务,行业共识认为,监控指标要留存历史数据,才能区分毛刺和趋势。
容器和cgroup场景
如果服务跑在Docker或Kubernetes里,直接在容器内看 free可能不准,因为看到的是宿主机视角。
docker stats看容器CPU、内存、网络、磁盘。cat /sys/fs/cgroup/memory.current看当前cgroup内存。cat /sys/fs/cgroup/cpu.stat看CPU使用统计。kubectl top pod看K8s Pod资源。
容器内数值受cgroup限制,不能直接等同宿主机总资源,排查时要同时看容器限制和节点水位。
Windows服务器查看CPU内存占用的命令
图形界面:任务管理器与资源监视器
Windows服务器最直接的是 Ctrl+Shift+Esc 打开任务管理器,性能选项卡看CPU、内存、磁盘、网络,想看更细的进程IO和句柄,运行 resmon 打开资源监视器。
长期记录用 perfmon,添加计数器:
Processor(_Total)% Processor TimeMemoryAvailable MBytesMemoryPages/secPhysicalDisk(_Total)% Disk Time
命令行:Get-Counter、wmic、typeperf
PowerShell里可以这样查:
Get-Counter 'Processor(_Total)% Processor Time'Get-Counter 'MemoryAvailable MBytes'Get-Process | Sort-Object CPU -Descending | Select-Object -First 10wmic cpu get loadpercentagewmic OS get FreePhysicalMemory,TotalVisibleMemorySizetypeperf "Processor(_Total)% Processor Time" -si 5 -sc 10tasklist /v看进程内存。
Linux与Windows常用工具对比
| 场景 | Linux常用 | Windows常用 |
|---|---|---|
| 整体CPU | top、uptime |
任务管理器、Get-Counter
|
| 整体内存 | free -h、/proc/meminfo |
任务管理器、wmic OS |
| 进程排序 | ps、htop、pidstat |
任务管理器、Get-Process |
| 历史趋势 | sar、vmstat |
perfmon、typeperf |
| 容器资源 | docker stats、cgroup |
任务管理器、容器工具 |
云服务器CPU内存使用率过高怎么排查
先分清楚整体高还是单进程高
打开云厂商控制台,先看实例维度的CPU和内存曲线,再登录服务器用 top、ps定位进程,若整体高但没有明显单进程,可能是宿主机争抢、监控口径差异,或者短时任务叠加,云服务器还要看 steal指标,steal高说明虚拟CPU被宿主机其他租户占用。
内存排查:available、cache、swap
内存高先看 available,再看 swap。available很低,si、so持续非零,说明在换页,查OOM记录:
dmesg | grep -i oomjournalctl -k | grep -i oom
如果程序被杀,日志里通常有OOM Killer记录,此时要么限制进程内存,要么升配,要么优化缓存策略。
CPU排查:us、sy、wa、steal
CPU高不一定是计算密集。us高看应用代码,sy高看系统调用和中断,wa高看磁盘IO,steal高看虚拟化争抢,业内专家指出,CPU使用率要结合load和IO等待一起看,单看一个数字容易误判。
历史与告警
临时排查靠命令,长期稳定靠监控,云监控可以设置CPU、内存、磁盘、网络阈值告警,自建方案常用 node_exporter + Prometheus + Grafana,北京机房服务器CPU内存监控怎么查?如果服务器在北京机房或国内云区域,优先用同地域云监控,减少跨地域网络延迟;自建Prometheus也尽量部署在同地域内网。
服务器监控工具免费和付费价格差多少
免费和开源方案
- 单机轻量:
htop、glances、nmon,软件免费。 - 中小集群:Netdata、Zabbix、Prometheus + Grafana,软件免费,但需要服务器和人力维护。
- 系统自带:
sar、vmstat、perfmon,适合基础排查。
付费和云托管方案
云厂商监控、Datadog、New Relic等通常按主机数、指标量、日志量、告警数计费,价格差异较大,小规模用免费版可能够用,规模上来后付费版省人力。服务器监控工具免费和付费价格差多少,关键看主机数量、指标保留时长和是否需要日志链路追踪。 不要只看软件授权费,还要算人力、存储和告警通道成本。
选择建议
- 1台到几台:
htop、free -h、任务管理器。 - 10台以内:Netdata或Zabbix。
- 容器和K8s:Prometheus + Grafana。
- 云上业务:云监控 + 自建Prometheus组合。
- 需要合规和长期存储:付费托管或自建时序数据库。
怎么查服务器的内存和CPU使用率常见问题
Linux下free显示内存快满了,是不是要加内存?
不一定,先看 available和 swap。buff/cache可回收,available低才说明应用可用内存不足,若 available长期偏低且 swap频繁使用,再考虑加内存或优化程序。
top里load average高,CPU使用率却不高,为什么?
load average包含运行中和不可中断的进程,磁盘IO慢、NFS卡顿也会推高load,结合 vmstat 1看 wa,再用 iostat -x 1看磁盘利用率,才能判断是不是IO瓶颈。
云服务器CPU内存使用率过高怎么排查?
先看云监控历史曲线,再登录服务器用 top、ps、pidstat定位进程,内存看 available、swap、OOM日志;CPU看 us、sy、wa、steal,若单进程持续高,优化或升配;若 steal高,联系云厂商,最终判断依据是监控历史、进程级指标和业务日志三者是否指向同一瓶颈。
查服务器CPU和内存使用率,核心就是先看整体、再定位进程、最后结合历史趋势和业务日志,命令只是入口,能解释指标背后的原因,才算真正会查。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/757921.html