科比服务器的警报体系覆盖硬件、网络、应用、安全四个层面,常见警报类型超过二十种,核心在于区分“提示性”与“致命性”警报,并建立分级响应机制。
科比服务器作为市面上常见的独立服务器管理面板,其警报系统设计的初衷是让运维人员从被动救火转为主动预防,很多站长第一次接触这套系统时,容易被满屏的通知搞懵,不知道哪些警报需要立刻处理,哪些只是例行提醒,这篇文章直接把这套警报体系拆开揉碎,按触发频率和危险程度排个序,让你心里有数。

硬件层警报:服务器最诚实的“身体信号”
硬件警报是整台机器健康状况的晴雨表,通常由主板传感器、IPMI接口或监控芯片主动上报,这类警报的特点是无法伪装,坏了就是坏了,延迟处理往往直接导致业务中断。
CPU温度与风扇转速警报
最常见的是CPU温度越过警戒线,多数机房设定的阈值在80℃到85℃之间,触发这类警报时,面板上通常会显示当前温度、风扇当前转速以及历史最高温记录,值得注意的是,风扇转速警报往往比温度警报早出现几分钟,如果你在面板里看到某颗风扇的转速突然掉到2000转以下,别犹豫,直接提交机房工单换风扇。
内存ECC纠错警报
这台服务器如果使用的是ECC内存,内存颗粒出现单比特翻转时,系统会静默修复,但面板会记录一条CE(Correctable Error)警报,如果同一根内存槽位频繁出现CE报错,行业共识认为这是内存颗粒老化的前兆,建议在下次维护窗口更换内存条,而UE(Uncorrectable Error)警报一旦出现,意味着内存已经无法自行修复数据,这类警报需要立即停机处理。
硬盘SMART状态与RAID阵列降级警报
硬盘警报是所有警报里最不能忽视的,因为数据丢失的代价远超硬件成本,SMART警报通常会在硬盘的05项(重映射扇区计数)或C5项(待映射扇区计数)数值异常时触发,RAID阵列降级警报则更直观面板上会显示“阵列状态:Degraded”,说明有一块盘掉线了。
| 警报类型 | 危险等级 | 建议响应时间 |
|---|---|---|
| RAID降级 | 致命 | 立即处理 |
| 硬盘SMART异常 | 严重 | 24小时内 |
| CPU温度越线 | 严重 | 4小时内 |
| 风扇转速异常 | 中等 | 当天处理 |
| ECC单比特翻转 | 提示 | 记录观察 |
网络层警报:链路质量决定用户体验
网络类警报直接关联访客能不能打开你的网站,科比服务器面板在网络监控这块做得相对细致,可以区分出带宽跑满、丢包率攀升、连接数异常三种核心场景。
入站与出站带宽跑满警报
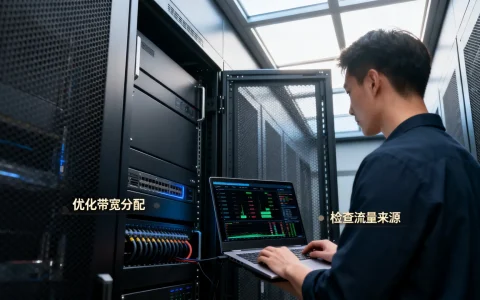
当你设置的带宽阈值低于实际峰值时,警报就会触发,面板会展示过去24小时的流量曲线图,帮助你确认是正常业务增长还是遭受了攻击,如果是正常业务增长,你需要考虑升级带宽套餐;如果是突发流量,就得检查防火墙日志中的来源IP分布。多数情况下,晚间8点到11点的带宽警报属于正常高峰,不必过度紧张。
丢包率与延迟抖动警报
这类警报往往比带宽警报更隐蔽,面板会通过ICMP或TCP探活来检测,当丢包率持续3分钟超过5%,或者延迟抖动超过基线值两倍时,会产生一条WARNING级别的警报,这里有个常见误区:香港或美国节点的服务器,跨国际链路的丢包率本身就在2%左右,阈值设置建议放宽到8%以上。
TCP连接数异常警报
连接数突然从几千飙到几万,大概率是两种情况:网站被CC攻击了,或者爬虫在疯狂抓取,面板里可以按源IP聚合连接数,帮你快速定位异常来源,如果单IP连接数超过几百,基本可以断定是恶意行为,处理手段一般是三步:防火墙封禁、配置CDN清洗、调整内核参数中的tcp_max_syn_backlog。
应用层警报:网站和业务是否正常运转
应用层警报是站长最关心的部分,直接关联网站是否打不开、接口是否报错,科比服务器面板支持自定义监控脚本,这意味着你不仅能监控端口连通性,还能监控特定进程是否存活、特定URL返回的状态码。
HTTP状态码异常警报
面板定时请求你设置的URL,如果返回码不是200、301或302,就会触发警报,这里有坑:如果你监控的页面本身嵌套了第三方资源,而第三方接口超时,可能导致整页加载超时,从而误报,监控URL最好是纯静态文件或简单的API健康检查接口。建议监控页面设置成返回JSON格式的轻量接口,而不是整个首页,因为首页内容越复杂,误报概率越高。
进程崩溃与重启警报
PHP-FPM、MySQL、Nginx这些核心服务一旦挂掉,面板会立刻推送警报,比较贴心的是,科比面板可以配置“自动重启”策略检测到进程不在了,系统自动拉起服务,但这里有个隐患:如果应用本身有死锁或内存泄漏,自动重启只是治标不治本,你需要查看进程崩溃前的系统日志,行业共识认为,自动重启措施适合临时应急,核心问题还是要翻日志定位根源。
磁盘空间使用率警报
磁盘告急是站长最容易忽视的警报,因为它在初期不影响业务,但一旦满盘,数据库会直接宕掉,面板中磁盘警报通常分两档:首次告警阈值在80%,第二次严重告警在90%以上,触发首次告警后,你应该执行以下排查步骤:
- 用
du -sh /检查根目录下哪个目录占用最大 - 重点排查
/var/log下的日志文件是否过大 - 检查数据库的binlog和慢查询日志是否定期清理
- 用
find / -size +1G找出单个大文件,确认是否为备份残留
安全层警报:服务器是否已被攻破
安全警报是警报体系中最让人紧张的一类,因为遭遇攻击意味着你的业务数据和用户隐私可能已经暴露,科比面板的安全警报模块包括登录失败检测、文件完整性校验和对外攻击行为检测。
SSH暴力破解警报
面板会统计连续登录失败的IP次数,当某个IP在短时间内尝试密码超过一定次数,警报就会生成,这类警报的高发场景通常出现在服务器公网IP暴露后的几个小时内,处理办法比较正规:改用密钥登录、修改默认SSH端口、安装fail2ban自动封禁,如果攻击流量已经大到日志刷屏,直接联系机房临时加黑洞或ACL规则是见效最快的手段。
WebShell与文件篡改警报
面板会对网站目录做哈希校验,发现核心文件被修改会产生警报,这类警报出现后,不要急着删文件,先看文件修改时间和对应的访问日志,确认入侵途径是上传漏洞还是后台弱口令,单纯删除WebShell而不修补漏洞,攻击者会换一个马再进来,问题照样存在。
对外DDoS行为警报
你的服务器变成肉鸡参与攻击时,机房会收到投诉,面板的同步警报也会响,这类警报意味着服务器已经被植入恶意进程,检查方法很简单:查看连接状态中大量SYN_SENT的连接,找出对应的进程PID,然后溯源这个进程是怎么启动的,处理完恶意进程后,建议重装系统或至少修改所有密码,因为你不知道攻击者在系统里留了多少后门。
如何高效处理科比服务器警报:推荐一套实用流程
警报处理最忌讳一视同仁,每一条都按最高优先级响应,会把人累垮,合理的思路是分级处理,把自己从警报噪音中解放出来。
第一步:设置合理的告警阈值
很多人的警报通知轰炸,根源是阈值设置太低,CPU使用率设成50%就报警,高峰期当然频繁触发。合理的CPU警报阈值应在85%到90%之间,且持续超过10分钟才触发;磁盘空间则按实际增长速率估算,留出至少一周的余量。
第二步:配置多渠道通知路由
不同等级的警报走不同的通知渠道,致命级的用电话或短信,严重级的用邮件或钉钉群机器人,提示级的只在面板内展示,这一步做扎实后,你的手机不会再半夜被震醒。
第三步:查看和处理服务器警报的具体步骤
登录科比服务器管理面板,左侧导航栏找到“监控告警”或“事件中心”,这里汇总了所有历史警报,点击具体条目,能看到触发时段的监控快照,处理完毕后,记得把处理结果填在备注里,方便后续复盘,如果不确定某条警报是否需要处理,可以在面板中查看触发规则的说明文档,或者临时将阈值调高观察一段时间。
科比服务器警报与主流监控工具对比
不少用户会问,是不是有了宝塔面板或云监控,就可以不用科比面板的警报了,两边应对的场景有重叠也有差异:
- 宝塔面板偏向应用层管理,监控粒度较粗,适合轻量级站点
- 简米云云监控擅长云产品关联告警,但依赖云环境生态
- Prometheus+Grafana灵活强大,适合专业运维,但配置门槛高
- 科比服务器警报胜在开箱即用,硬件层和网络层监控集成度较高
从性价比角度看,如果你用的是物理服务器,科比面板的硬件监控能力明显比纯应用层面板更让人安心,如果跑的是云服务器,云厂商自带的监控已经足够,可以不用再折腾。
关于科比服务器警报的常见疑问解答
Q:收到服务器警报后,是否必须24小时全天候处理?
不需要也不现实,需要按时效分级应对:致命级警报(如RAID降级、数据盘只读)要求立即处理,否则数据安全没有保障;严重级警报(如CPU持续满载、带宽跑满)允许在业务低峰处理;提示级警报(如单次丢包、ECC单比特翻转)记录在案,观察趋势即可,即使处理及时,也要记得定期查看历史警报记录,把反复出现的隐患一次性解决。
Q:科比服务器警报里的自动重启功能靠谱吗,能否依赖它代替人工?
自动重启可以当作用来争取时间的临时手段,但不能作为长期依赖,举个例子,如果Nginx进程频繁崩溃,自动重启确实能保证服务“看起来在线”,但根本原因可能是代码内存溢出、磁盘只读或配置错误,不查清根源,崩溃只会越来越频繁,最终覆盖掉人工的响应窗口。
Q:有没有办法减少服务器警报的误报?
误报的根源在于监控规则与业务特征不匹配,可以从三个方向优化:一是调整阈值,让告警线贴合业务的真实水位;二是增加持续时间参数,要求异常持续数分钟才触发,容忍瞬时抖动;三是区分工作日和节假日的流量模型,高峰时段用更宽的阈值,这些设置在科比面板的监控规则中均可修改,完成调优后误报数量会明显下降。
Q:服务器警报太多会不会影响性能?
监控进程本身的开销较低,通常情况下CPU占用不到2%,可以忽略不计,如果日志量巨大导致磁盘写入频繁,可以适当调整日志轮转策略,将监控日志保留周期缩短到7天或更短,监控的意义在于预警而非记账,保留周期太长的日志价值不大,反而可能拖累磁盘性能。
成套的警报体系是一台服务器稳定运行的长期保障,熟悉了各类警报的含义与应对方式,服务器才能真正成为你业务的安全底座,在设置每一项警报之前,先问自己一个问题:这条规则触发之后,我打算采取什么动作?如果答不上来,这条规则还需要再调整。
首发原创文章,作者:王坚,如若转载,请注明出处:https://idctop.com/article/705374.html